

Olewave의 음성 데이터 청소 파이프라인을 효과적이고 독특하게 만드는 것은 무엇인가
Olewave의 Olign 파이프라인이 원본 오디오를 실제 서비스에 바로 쓸 수 있는 ASR/TTS 학습 데이터로 바꾸는 방법을 소개합니다. 이 데이터에는 검증된 전사문, 단어 단위 타임스탬프, 신뢰도 점수가 포함되며, 사람 레이블러는 필요하지 않습니다.

Olewave의 최첨단이며 폭넓은 맞춤 설정이 가능한 음성 데이터 정제 파이프라인은 음성 데이터 수집 파이프라인과 매끄럽게 통합됩니다. 두 파이프라인이 함께 Olewave의 음성 데이터 큐레이션 파이프라인을 이룹니다. 이 엔드투엔드 시스템은 다양한 다운스트림 애플리케이션에 맞춰 고품질이면서 일관되고 비용 효율적인 음성 데이터셋을 대규모로 제공하도록 세심하게 설계되었습니다. 또한 저희 파이프라인으로 큐레이션한 대규모의 비용 효율적인 음성 데이터셋을 제공합니다. 이 데이터셋은 여러 언어로 이용할 수 있으며 다양한 주제를 다룹니다.
아래 그림은 저희 음성 데이터 정제 파이프라인의 간결한 워크플로를 보여 줍니다. 이 파이프라인은 가공되지 않은 비정형 음성 데이터를 잘 정돈되어 바로 쓸 수 있는 데이터셋으로 바꿉니다.
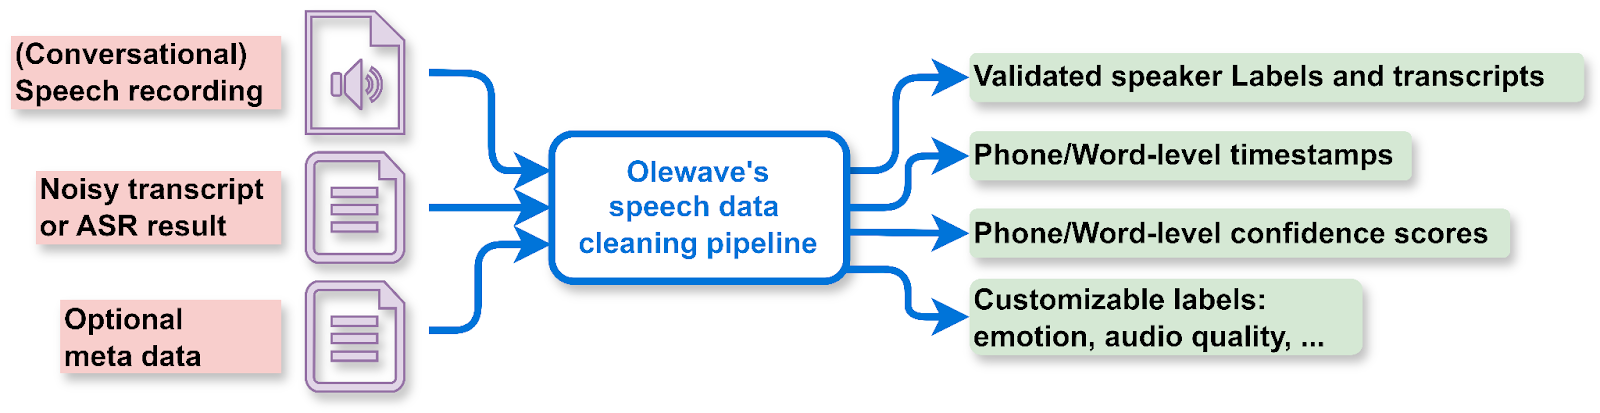
저희 파이프라인에는 여러 장점이 있습니다.
- 효과성. Whisper 및 다른 오픈소스 도구와 비교할 때, 검증된 화자 레이블과 전사 결과, 정확한 단어 타임스탬프, 과신하지 않는 신뢰도 점수를 제공합니다.
- 견고성. 즉흥적인 대화체 음성을 처리합니다. 화자가 겹치는 상황이나 ASR 오류가 포함된 전사문도 다룰 수 있습니다.
- 확장성. 선택적 메타데이터를 활용하며, 레이블 신뢰도를 높이기 위해 추가 모달리티를 통합하도록 업그레이드할 수 있습니다. 또한 이 파이프라인은 Olewave 또는 고객의 자체 레이블 태깅 모델(예를 들어 감정, 의미 등)을 플러그 앤 플레이 방식으로 통합할 수 있도록 지원합니다.
- 효율성. GPU 자원이 거의 또는 전혀 필요하지 않아 빠르게 실행되며 비용 효율적입니다.
또한 사람 어노테이터가 자동 음성 인식(ASR) 결과를 다듬도록 하는 것이 목표라면, 저희 파이프라인의 출력은 두 가지 방식으로 레이블링 비용을 크게 줄여 줍니다.
- 정확한 시간 정보로 단어를 정밀하게 강조 표시합니다. 어노테이터는 전체 오디오를 반복해서 듣지 않고도 웅얼거리거나 불분명한 구간을 빠르게 찾아 검토할 수 있습니다.
- 중간 범위의 신뢰도 점수를 가진 단어에 어노테이터가 집중하도록 안내합니다. 모든 단어를 검토할 필요가 줄어 교정 과정이 간소화됩니다.
이처럼 핵심을 짚어 주는 정보를 제공하여 저희 파이프라인은 효율을 높이고 수작업을 줄이며, 더 비용 효율적인 어노테이션 워크플로를 만들어 줍니다.
아래는 화자 레이블, 단어 단위 타임스탬프, 신뢰도 점수를 보여 주는 파이프라인 출력의 시각화 예시입니다.
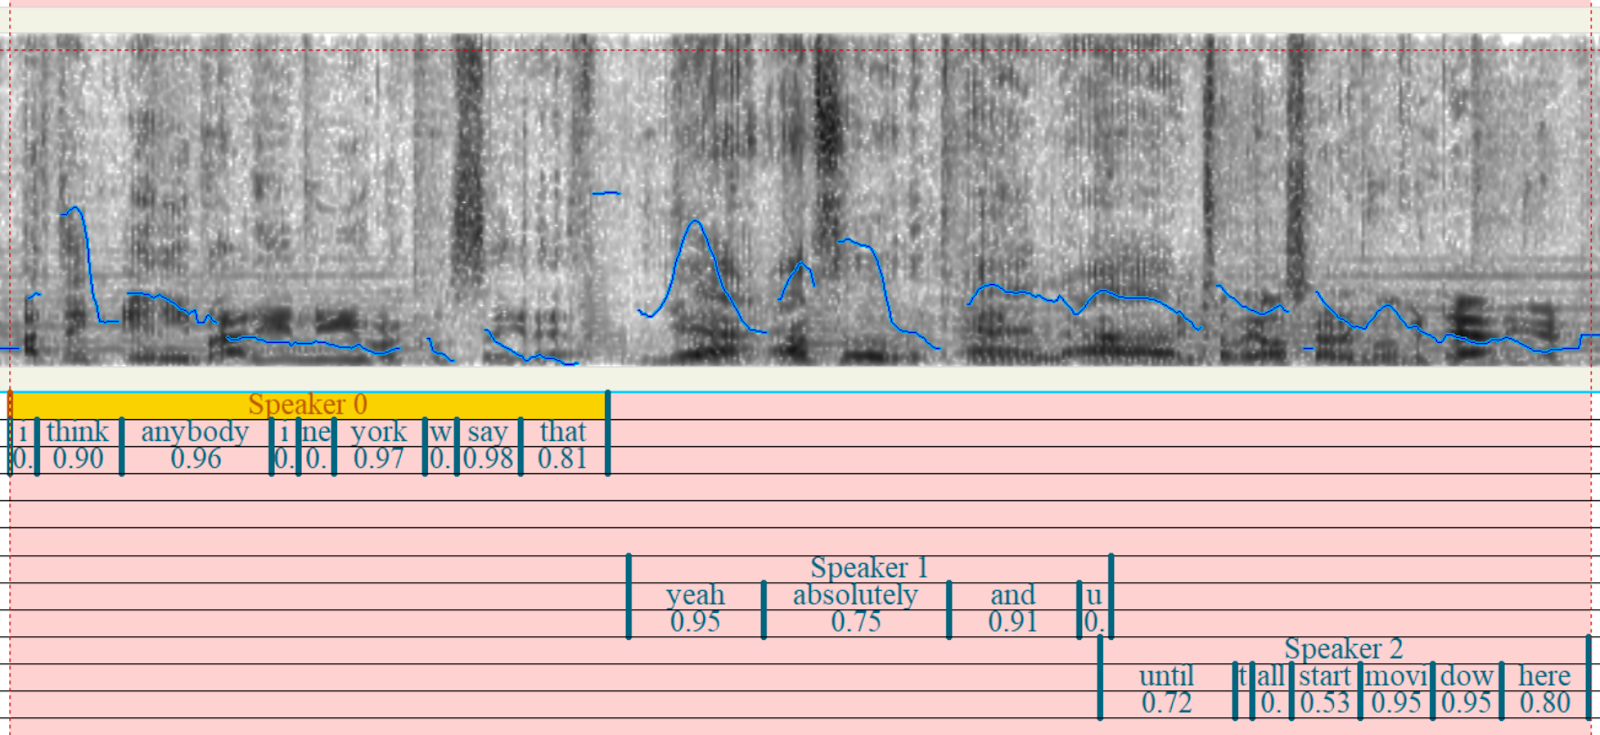
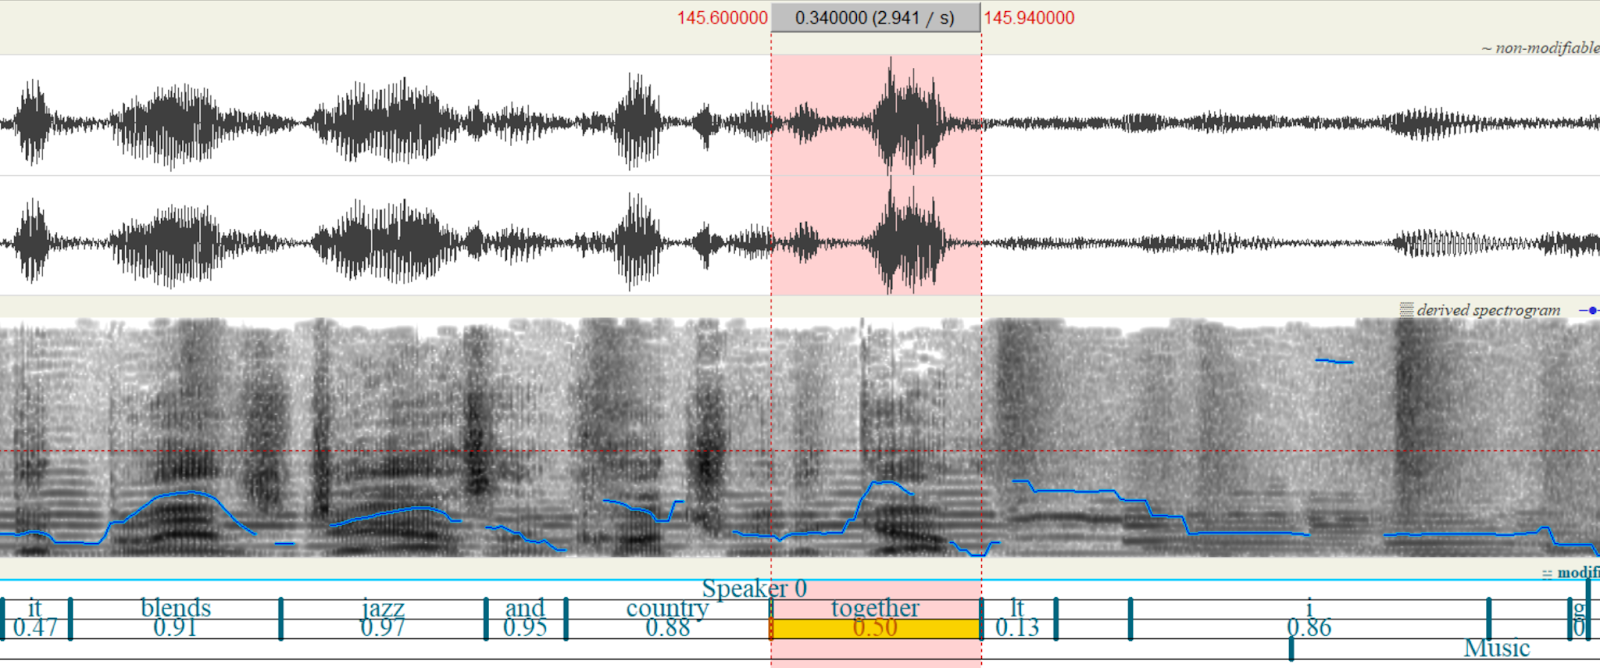
대규모 엔드투엔드(E2E) 프레임워크와 대규모 E2E ASR 모델은 각각 정확한 단어 단위 타임스탬프와 신뢰할 수 있는 단어 단위 신뢰도 점수를 만들어 내는 데 본질적인 한계가 있습니다. 이는 학계와 업계 모두에서 널리 인정되는 사실입니다.
이러한 한계를 해결하기 위해 저희는 엔드투엔드가 아닌 음성-텍스트 정렬 기법에 대한 깊은 전문성을 활용하고, 메타데이터 정보를 반영하는 정교한 절차를 개발했습니다. 이 접근 방식은 전사문에서 발화되지 않은 내용(예를 들어 필러 단어, 배경 소음 표기)을 효과적으로 제거합니다. 그 결과 최종 출력의 정확도와 신뢰성이 더 높아집니다.
다음은 데이터 파이프라인이 출력하는 단어 단위 JSON의 일부입니다. 'speaker' 필드는 이 녹음에서 화자 id를 나타냅니다. 'start_time'과 'end_time' 필드는 초 단위이며, 화자가 말한 시간 구간을 나타냅니다. 'block' 필드에는 같은 화자의 연속된 발화가 하나 또는 여러 개 들어 있습니다. 각 발화에는 시작 시간, 종료 시간, 전사문, 화자 겹침 표시, 신뢰도 점수가 각각 있습니다. 'overlap' 필드 값이 true라면 현재 구간이 인접한 구간과 화자가 겹친다는 뜻입니다. 신뢰도 점수는 0에서 1 사이의 값입니다.
{
        "speaker": 0,
        "start_time": "47.18",
        "end_time": "49.83",
        "block": [
            {
                "start_time": "47.18",
                "end_time": "49.83",
                "transcript": "music-related jobs compared to New York and LA.",
                "overlap": false,
                "word_details": [
                    {
                        "start_time": "47.18",
                        "end_time": "47.53",
                        "word": "music",
                        "confidence": "0.97"
                    },
                    {
                        "start_time": "47.53",
                        "end_time": "47.89",
                        "word": "related",
                        "confidence": "0.79"
                    },
                    {
                        "start_time": "47.89",
                        "end_time": "48.44",
                        "word": "jobs",
                        "confidence": "0.98"
                    },
                    {
                        "start_time": "48.44",
                        "end_time": "48.90",
                        "word": "compared",
                        "confidence": "0.96"
                    },
                    {
                        "start_time": "48.90",
                        "end_time": "48.96",
                        "word": "to",
                        "confidence": "0.17"
                    },
                    {
                        "start_time": "48.96",
                        "end_time": "49.08",
                        "word": "new",
                        "confidence": "0.97"
                    },
                    {
                        "start_time": "49.08",
                        "end_time": "49.37",
                        "word": "york",
                        "confidence": "0.98"
                    },
                    {
                        "start_time": "49.37",
                        "end_time": "49.49",
                        "word": "and",
                        "confidence": "0.92"
                    },
                    {
                        "start_time": "49.49",
                        "end_time": "49.83",
                        "word": "la",
                        "confidence": "0.56"
                    }
                ]
            }
        ]
    },