


OpenAI Whisper에서 자체 ASR 서비스로: 이름 엔티티 및 도메인별 용어 인식
Whisper는 즉시 인상적이지만, 실제로 프로덕션에 배포한 사람이라면 누구나 고통을 알고 있습니다: 고유명사, 제품 이름, 의료 용어, 법률 용어, 그리고 도메인 어휘의 전체 긴 꼬리를 잘못 처리합니다

ICASSP 2024에서의 Olewave
우리는 서울의 IEEE ICASSP 2024의 후원사이자 전시업체였으며, 당사의 설립자이자 CEO인 Wei Chu가 야생 웹 소싱 데이터로부터 음성 모델 훈련에 대한 초대 연설을 진행했습니다.

변분 자동인코더(VAE) 및 재매개변수화 트릭 - 고전 생성 모델 재검토
확산 모델이 나오기 전에, 정규화 흐름이 나오기 전에, 잠재 확산 모델이 조용히 VAE 인코더를 모든 진지한 생성 스택에 구축하기 전에 — Kingma와 Welling의 2013년 논문이 변분 자동인코더를 소개

Microsoft+OpenAI, Google, Meta, 및 Nvidia의 오픈 소스 대규모 음성 모델 검토(ASR용)
모든 주요 AI 연구소는 이제 ASR용 오픈 소스 대규모 음성 모델을 출시했으며, 프로덕션용으로 올바른 모델을 선택하는 것이 실제 결정이 되었습니다.
Tycho: 높은 ROI 자체 음성 관련 서비스(ASR/TTS/번역) 구축을 위한 툴킷: 개요
자체 ASR, TTS, 또는 음성 번역 서비스를 원하는 대부분의 팀은 동일한 복잡한 선택에 직면합니다: ESPnet, NeMo, k2, HuggingFace의 조각들을 붙이거나, 모든 것을 클라우드 API에 넘기고 분당 비용을 지불

OpenAI의 Whisper 모델에서 자신의 자체 ASR 서비스로: 후처리 및 언어 모델링
원본 Whisper 출력은 기본 상태에서 인상적이지만, 실제 사용자에게 배포한 모든 사람은 데모 트랜스크립트와 다운스트림 시스템이 실제로 사용할 수 있는 것 사이의 간격을 알고 있습니다.
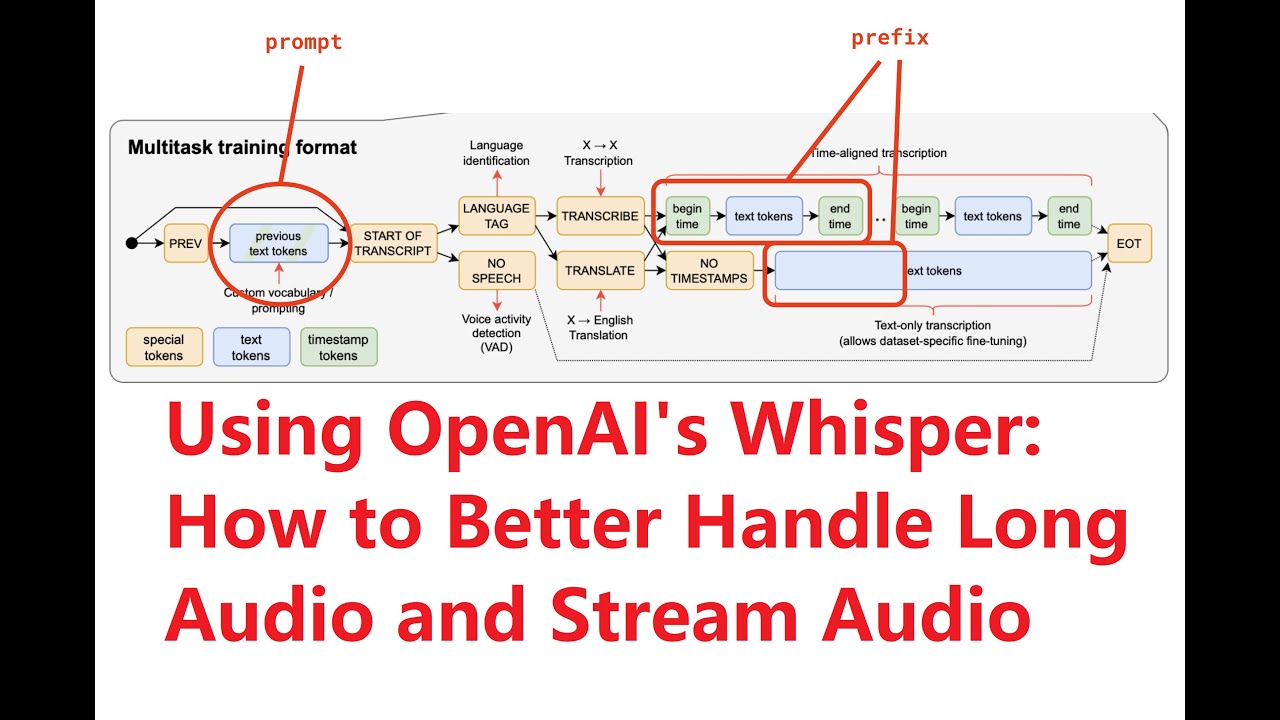
OpenAI의 Whisper 모델에서 자신의 자체 ASR 서비스로: 긴 오디오 및 스트리밍 (Part 3)
Whisper는 30초 청크로 학습되었으며, 2시간 팟캐스트를 입력하거나 라이브 캡션 파이프라인에 연결하려고 할 때 한계를 드러냅니다.
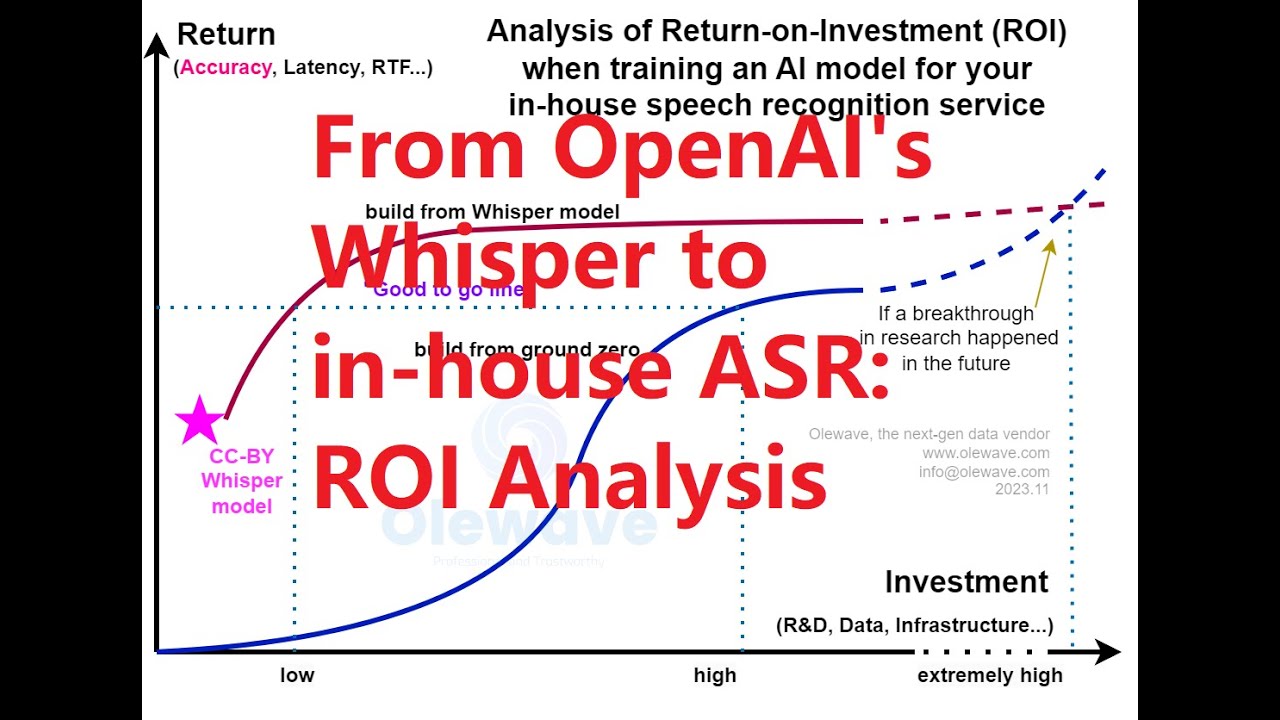
OpenAI의 Whisper 모델에서 자신의 자체 ASR 서비스로: ROI (투자 수익률) (Part 2)
ASR의 구축 대 구매 질문은 일반적으로 정확도 대 편의성으로 프레임화되지만, 실제 결정 요소는 제품 수명 동안의 ROI입니다.
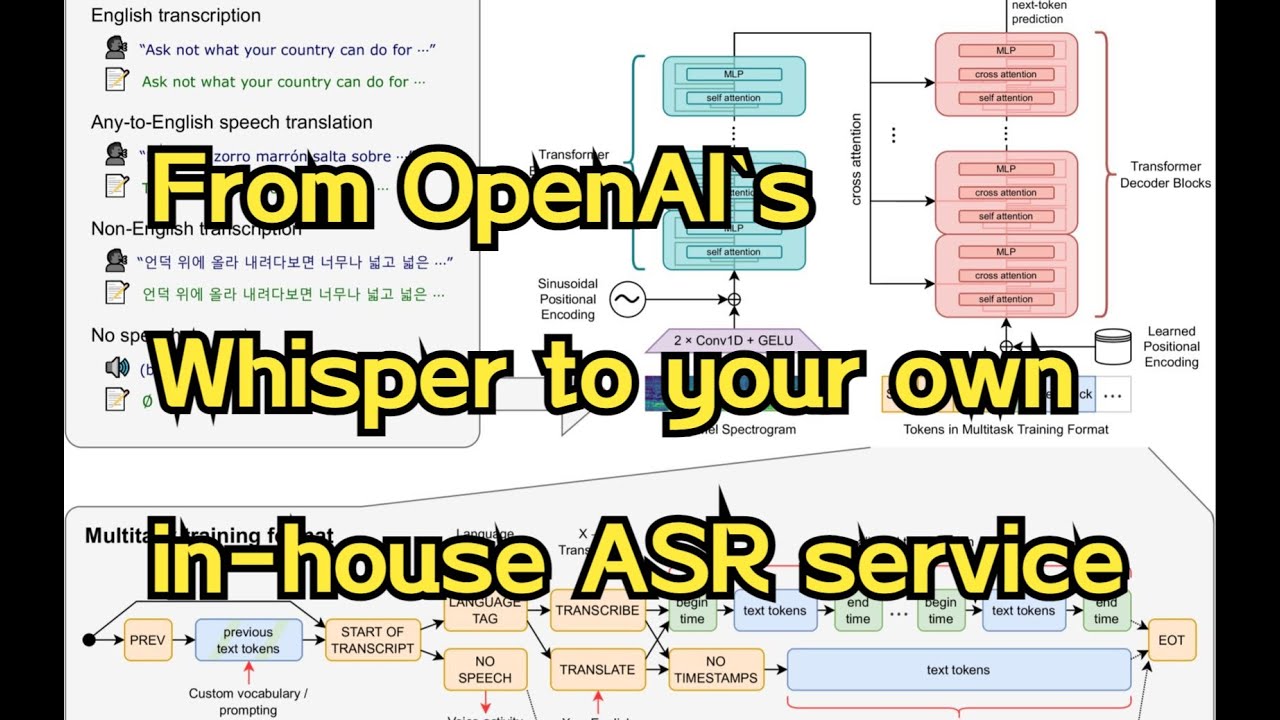
OpenAI의 Whisper 모델에서 자신의 자체 ASR 서비스로: 개요 (Part 1)
OpenAI가 Whisper를 오픈소스로 공개했을 때, 자체 ASR 서비스가 어떻게 보이는지에 대한 기준선을 조용히 재설정했습니다.

OpenAI Whisper가 생성한 단어 타임스탐프가 정확하지 않은 이유는? 다시 정확하게 만들 수 있을까?
Whisper에 단어 타임스탐프를 요청하면 숫자가 반환됩니다 — 하지만 실제 오디오와 맞춰보려고 시도한 경험이 있다면, 노래방, 자막, 더빙을 위해 드리프트가 발생하고 잘못된 경계로 스냅되며 가끔은
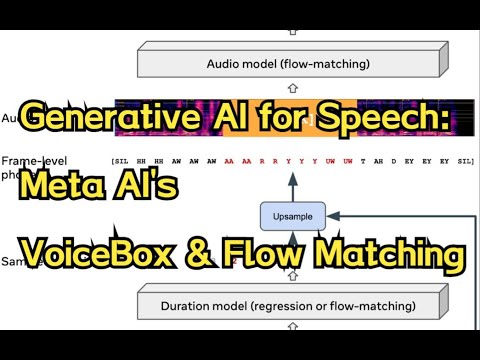
음성 생성 AI: Meta AI의 VoiceBox(Flow Matching과 Neural ODE도)
수년 동안 음성 생성은 규모와 일반성 측면에서 텍스트 및 이미지 생성에 뒤떨어졌습니다 — 모든 작업은 자체 맞춤형 모델을 사용했습니다.

I-JEPA: Yann LeCun의 첫 번째 '세계 모델' 컴퓨터 비전용
Yann LeCun은 수년 동안 생성형 사전 훈련이 세계를 이해하는 기계를 만들기 위한 잘못된 베팅이라고 주장해왔습니다.
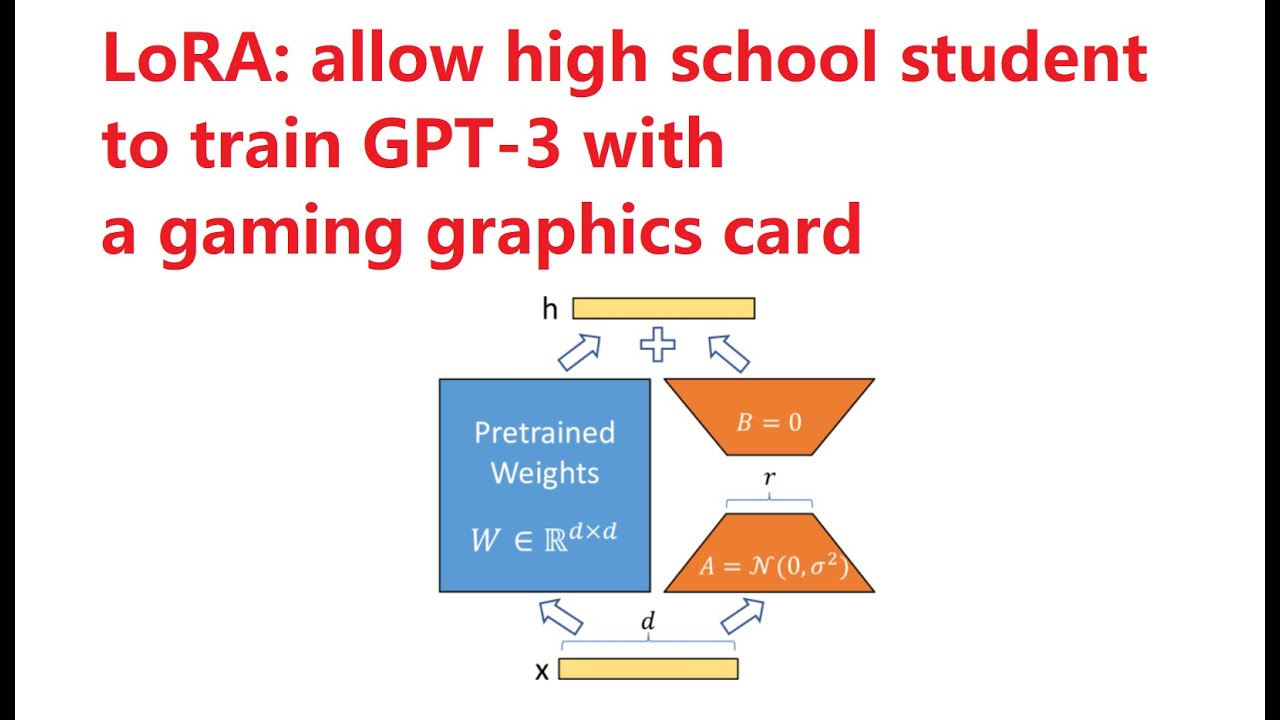
LoRA: 고등학생도 게이밍 그래픽 카드로 대규모 언어 모델(GPT-3)을 훈련할 수 있게 하다
175B 파라미터 GPT-3의 전체 미세 조정은 거의 모든 사람에게 현실적이지 않습니다 — 저장 공간만으로도 불가능하며, GPU는 말할 것도 없습니다.

SpeechT5 리뷰: 음성(ASR, TTS, SID, ...) 작업에 Google의 T5 도입하기
T5는 단일 인코더-디코더 사전 훈련 방식 아래에서 텍스트-텍스트 작업을 통합했으며 NLP의 핵심 도구가 되었습니다.
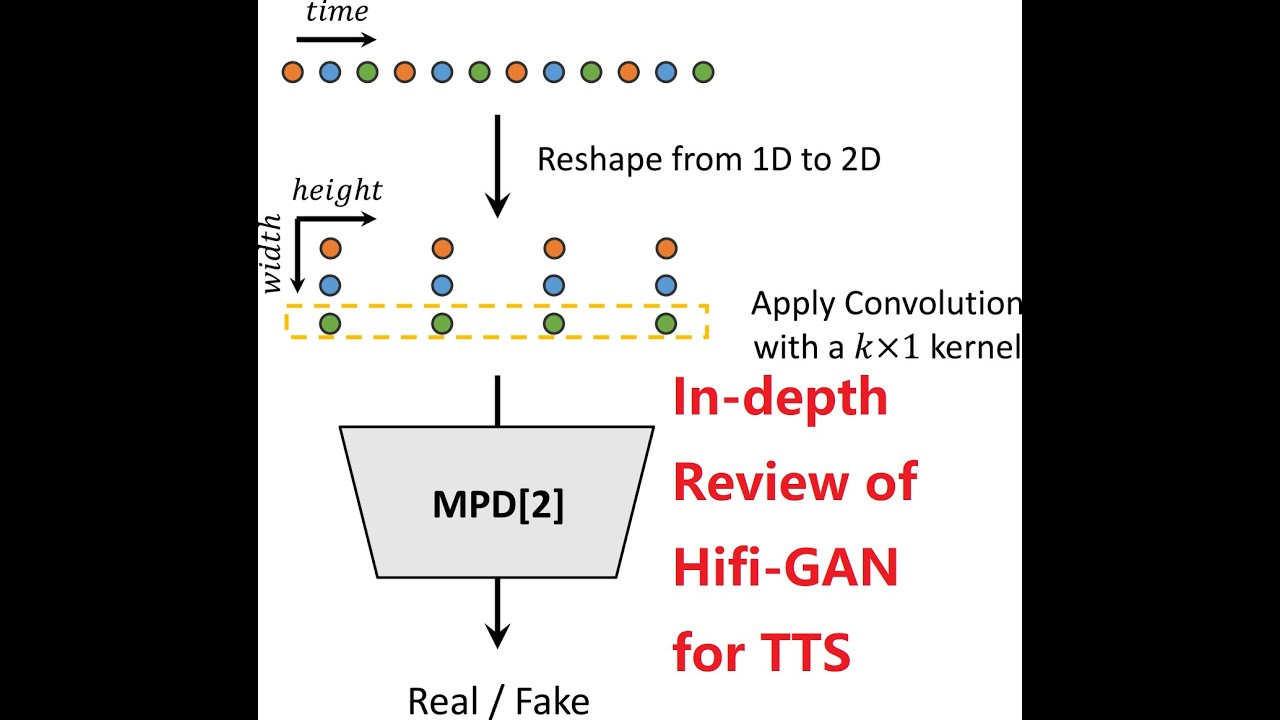
HiFi-GAN 리뷰: 효율적이고 고충실도 음성 합성을 위한 생성 적대 네트워크
오랫동안 신경 보코더는 선택을 강요했습니다: WaveNet과 같은 자동회귀 모델은 아름다운 오디오를 제공했지만 고통스럽게 느렸고, GAN 기반 파형 생성기는 빠르지만 눈에 띄게 낮은 품질이었습니다.

Google의 SoundStream 심층 리뷰: 엔드-투-엔드 신경 오디오 코덱
신경 코덱은 조용히 현대 생성 오디오의 기초 계층이 되었고, SoundStream은 시작을 신호한 논문 중 하나입니다.
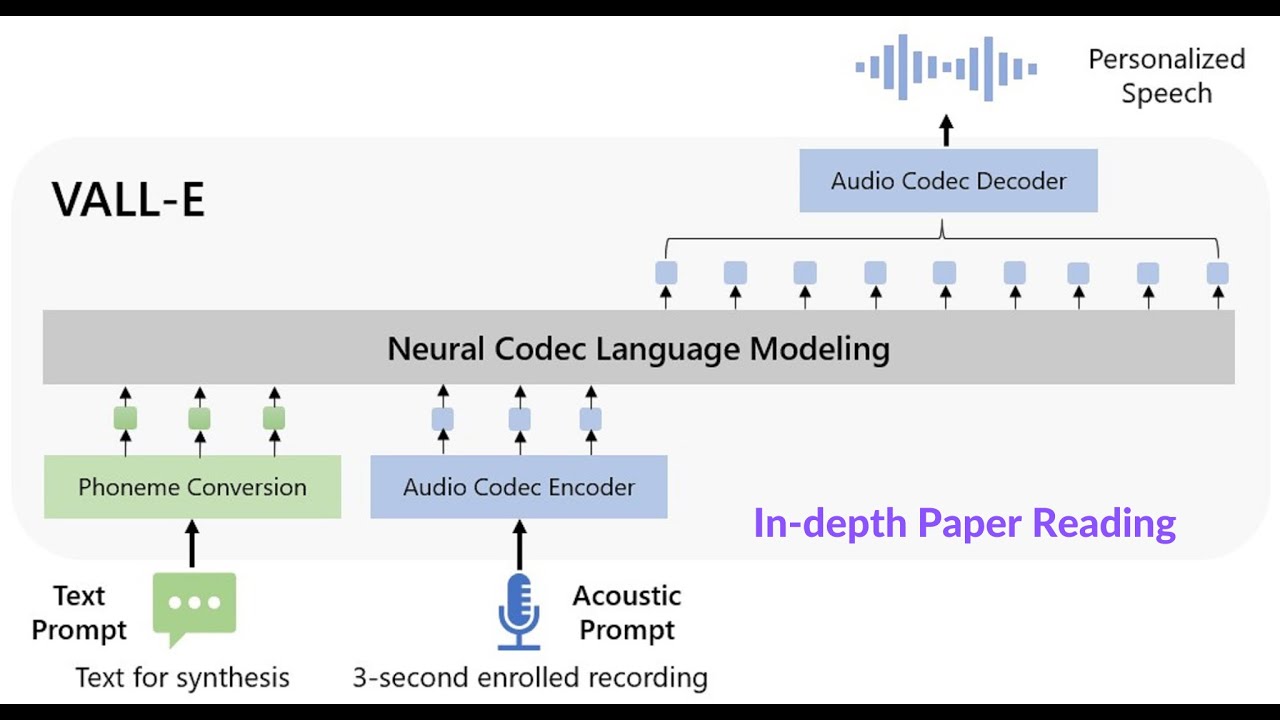
VALL-E의 심층 리뷰: 신경 코덱 언어 모델이 영샷 텍스트 음성 합성기
3초 참고 클립으로부터의 영샷 TTS는 VALL-E가 출시될 때까지 불가능해 보였지만, 이 심층 리뷰는 Microsoft가 정확히 어떻게 이를 달성했는지를 상세히 설명합니다.
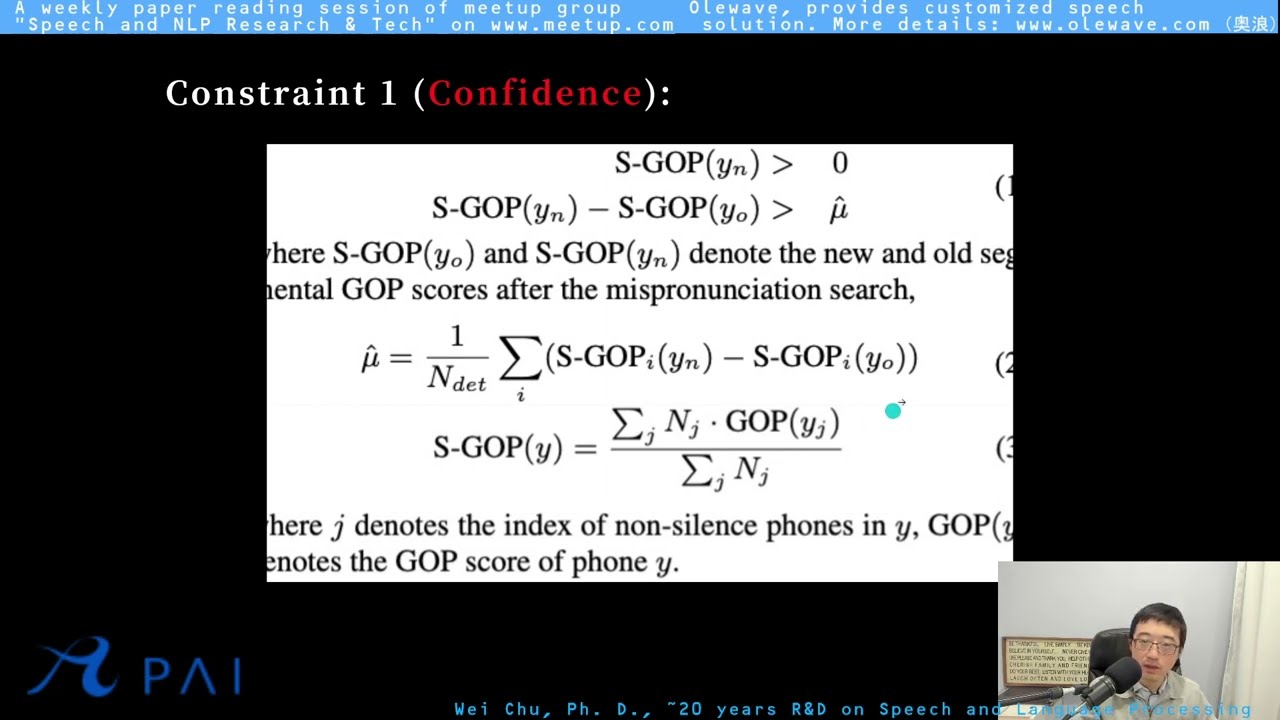
Non Collision Mispronunciation Addition (NCMA) for 사투리 ASR
사투리와 비원어민 음성은 발음 사전을 파괴하여 음성 모델 정렬을 조용히 오염시키는데, 이 Interspeech 2021 작업은 기만적으로 단순한 질문을 던집니다: 우리가 탐지된 오발음을 단순히 사전에 추가하면

One-Edit-Distance FSA/Network-based (OEDN)를 이용한 오발음 탐지 및 사투리 ASR
비원어민 음성 모델링은 닭과 계란 문제를 가지고 있습니다: 나쁜 음성 정렬은 나쁜 모델을 만들고, 나쁜 모델은 나쁜 정렬을 만듭니다.

[Olewave의 단편 리뷰] Xception: 깊이별 분리형 컨볼루션을 이용한 딥러닝
Xception의 핵심 아이디어만 원하고 장편 리뷰의 깊은 내용은 원하지 않는다면, 이 단편 리뷰가 간단한 버전입니다.

[단문 리뷰] Conformer: 음성 인식을 위한 Convolution-augmented Transformer
Conformer는 거의 단순한 작업을 통해 ASR 세계를 휩쓸었습니다: 각 Transformer 블록에 convolution 모듈을 붙여 모델이 전역 컨텍스트와 로컬 음향 세부 정보를 한 번에 포착할 수 있도록 했습니다.

박사 아저씨가 컴퓨터로 2022 대입 수학 시험의 최종 문제를 풀다
연구용 컴퓨터 대수학 도구를 2022 중국 가오카오 수학 시험의 가장 어려운 문제에 사용하면 어떤 일이 일어날까요?

[롱 리뷰] Wav2Seq: Pseudo Languages를 사용한 Speech-to-Text Encoder-Decoder Models의 Pre-training
대부분의 speech pretraining은 encoder 측면에 집중했습니다: wav2vec, HuBERT, WavLM, 하지만 sequence-to-sequence ASR은 pretrained decoder도 필요합니다.


[Long Review] 훈련 데이터 중복 제거가 언어 모델을 더 좋게 만든다
중복 제거는 지루해 보이지만, C4 내에 61개 단어로 된 문장이 60,000번 이상 나타나고, 이런 말뭉치로 훈련된 언어 모델이 훈련 세트 텍스트를 불안하게 re
세쌍둥이처럼 닮은 러시아 피겨 스케이터들: Kullback-Leibler 발산이 그들의 차이를 구별할 수 있습니까?
스피커 적응은 시퀀스-투-시퀀스 모델을 인코더의 어렵게 획득한 음향 표현을 손상시키지 않고 적응시키려고 실제로 시도할 때까지 해결된 것처럼 들리는 ASR 문제 중 하나입니다.
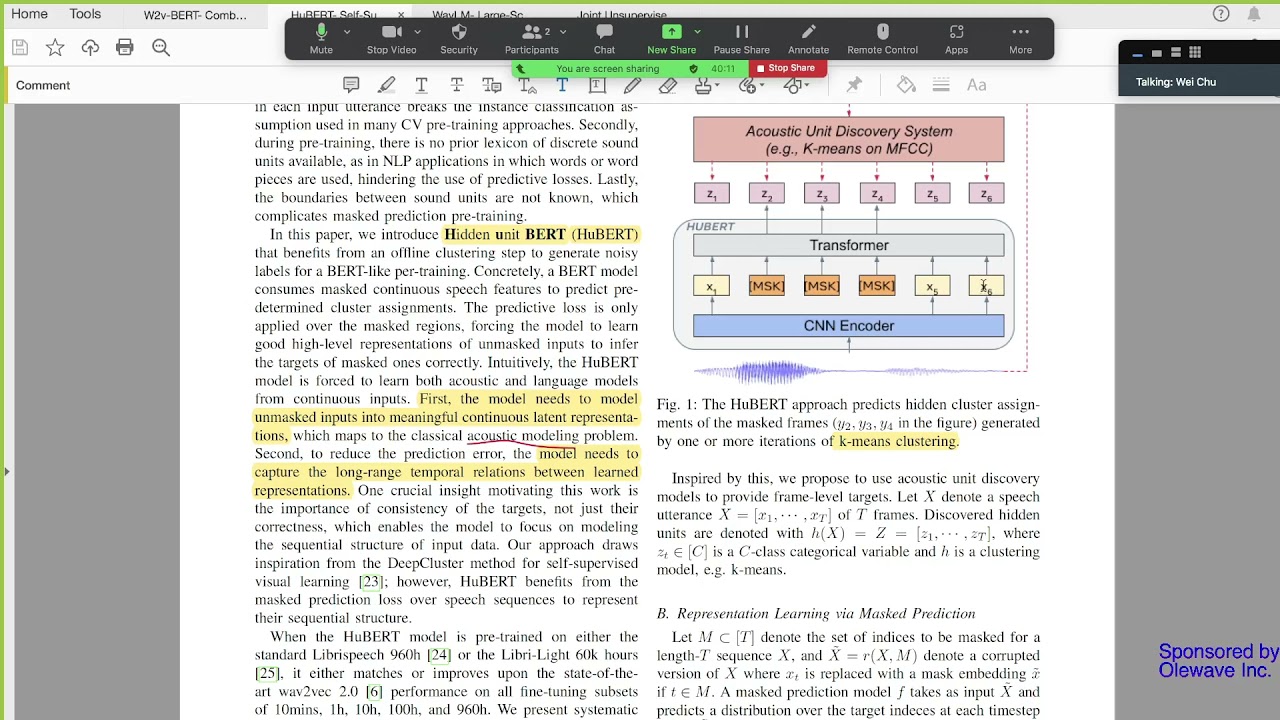
HuBERT: 숨겨진 단위의 마스킹 예측을 통한 자체 지도 음성 표현 학습
wav2vec 2.0이 대조적 자체 지도로 게임을 바꿨지만, HuBERT는 더 날카로운 질문을 제시했습니다: 대조적 트릭을 완전히 건너뛰고 음성에서 BERT 스타일의 마스킹 예측을 수행하면 어떨까요?

W2v-BERT: 대조 학습과 마스킹된 언어 모델링을 결합한 자체 지도
음성 사전 학습을 위해 대조 학습과 마스킹된 언어 모델링 중에 선택해야 할 때 둘을 같은 네트워크에 연결할 수 있다면 왜 선택해야 할까요?


다국어 ASR을 위한 공동 비지도학습 및 지도학습 훈련
사전 훈련 후 미세 조정이 다국어 ASR의 기본 레시피가 되었지만, 많은 잠재력을 남기고 있습니다: 두 단계가 손실을 공유하지 않으며, 지도 단계가 유용한 자체 지도 구조를 조용히 제거할 수 있습니다