

是什么使Olewave的语音数据清洗管道有效且独特
Olewave 的 Olign 流水线如何在无需人工标注员的情况下,把原始音频转化为可直接用于生产的 ASR/TTS 训练数据,并提供经过验证的转写文本、词级时间戳和置信度分数。

Olewave 先进且高度可定制的语音数据清洗流水线与其语音数据采集流水线无缝集成,共同构成了Olewave 的语音数据整理流水线。这套端到端系统经过精心设计,可大规模交付高质量、高一致性、高性价比的语音数据集,并面向各类下游应用量身定制。此外,我们还提供经由该流水线整理的大规模、高性价比的语音数据集,包含多种语言,涵盖各类主题。
下图展示了我们语音数据清洗流水线的精简工作流程。它能够将原始、非结构化的语音数据转化为精良、可直接使用的数据集。
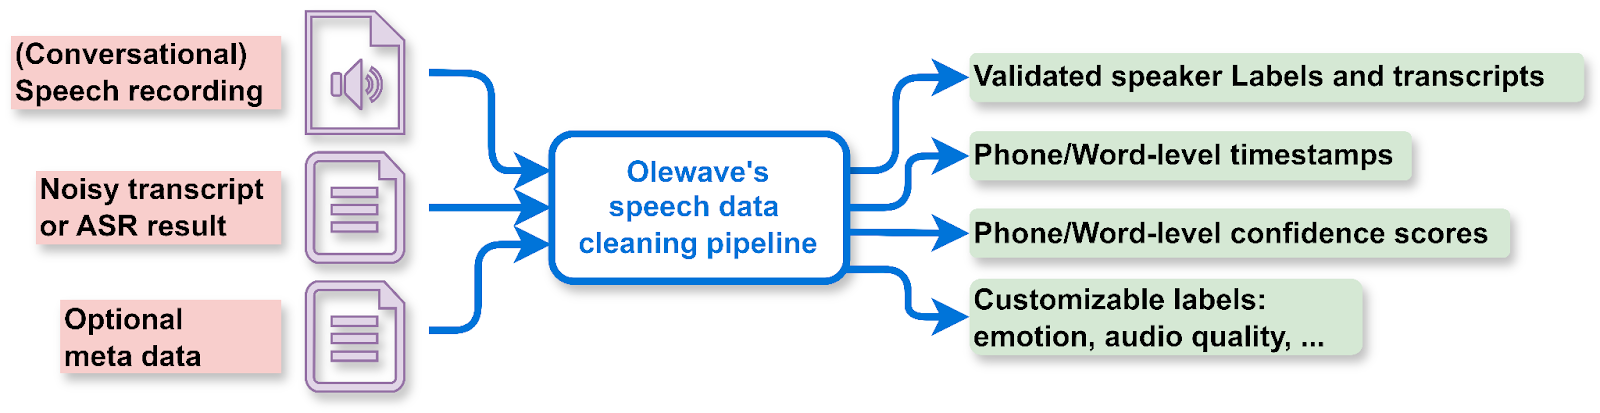
我们的流水线具备多项优势。
- 有效。与 Whisper 及其他开源工具相比,它能产出经过验证的说话人标签和转写文本、准确的词级时间戳,以及不过度自信的置信度分数。
- 稳健。它能处理即兴的对话语音,包括说话人重叠的场景,以及转写文本中含有 ASR 错误的场景。
- 可扩展。它可以利用可选的元数据,还能通过升级引入额外的模态,以提高标签的可靠性。该流水线还支持即插即用地集成 Olewave 或客户自有的各类标签标注模型(例如情感、语义等)。
- 高效。它运行速度快,成本效益高,因为它不需要或只需要很少的 GPU 资源。
此外,如果你的目标是让人工标注员精修自动语音识别(ASR)的结果,我们流水线的输出可以从两个方面显著降低标注成本。
- 精确高亮带有准确时间信息的单词,让标注员无需反复听完整段音频,就能快速定位并复核含糊或不清晰的片段。
- 引导标注员重点关注置信度分数为中等的单词,尽量避免逐词复核,并简化修正流程。
通过提供这些有针对性的信息,我们的流水线可以提升效率,减少人工投入,并确保标注流程更具成本效益。
下面是该流水线输出的可视化示例,展示了说话人标签、词级时间戳和置信度分数。
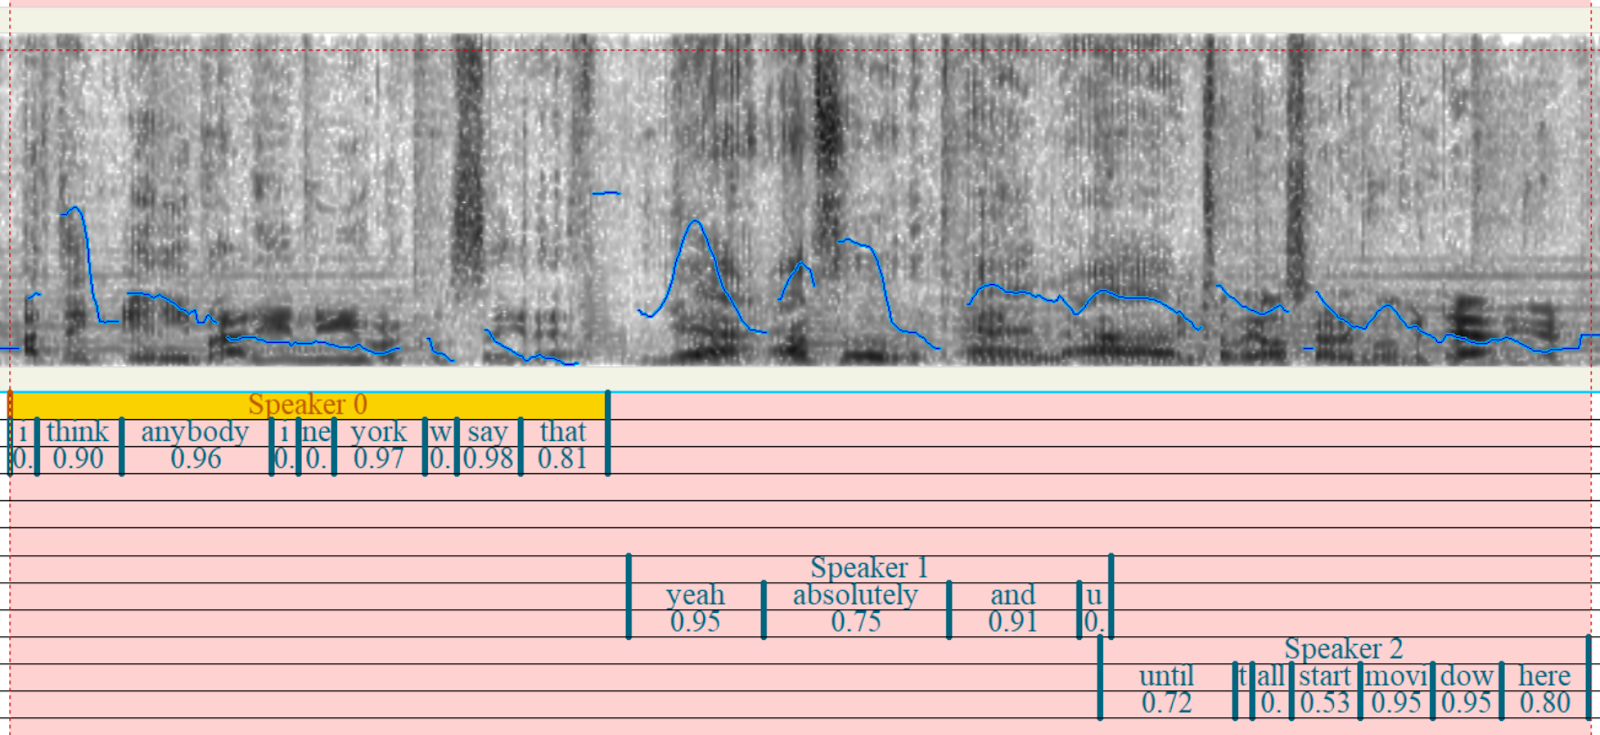
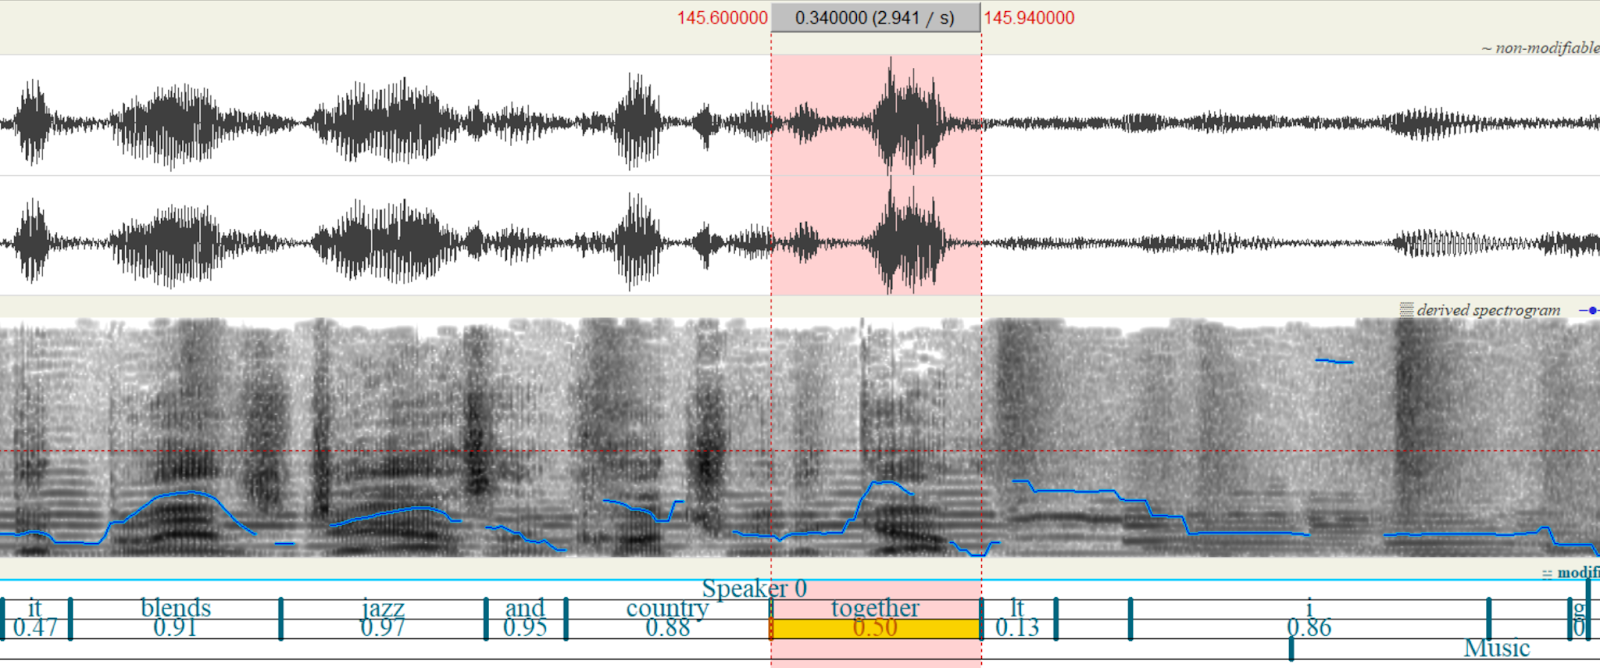
学术界和工业界普遍认为,大型端到端(E2E)框架和大型 E2E ASR 模型分别在生成准确的词级时间戳和可靠的词级置信度分数方面存在固有的局限。
为了解决这些局限,我们发挥在非端到端的语音文本对齐技术方面的深厚专长,开发了融入元数据信息的精密流程。这种方法让我们能够有效地从转写文本中清除非口语内容(例如填充词、背景噪声的转写)。这确保了最终输出具有更高的准确性和可靠性。
下面是该数据流水线输出的词级 JSON 片段。“speaker”字段表示这段录音中说话人的 ID。“start_time”和“end_time”字段以秒为单位,表示该说话人发言的时间跨度。“block”字段包含同一说话人的一句或多句连续话语。每句话语都有各自的开始时间、结束时间、转写文本、说话人重叠标记和置信度分数。当“overlap”字段为 true 时,表示当前片段与相邻片段存在说话人重叠。置信度分数的取值范围是 0 到 1。
{
        "speaker": 0,
        "start_time": "47.18",
        "end_time": "49.83",
        "block": [
            {
                "start_time": "47.18",
                "end_time": "49.83",
                "transcript": "music-related jobs compared to New York and LA.",
                "overlap": false,
                "word_details": [
                    {
                        "start_time": "47.18",
                        "end_time": "47.53",
                        "word": "music",
                        "confidence": "0.97"
                    },
                    {
                        "start_time": "47.53",
                        "end_time": "47.89",
                        "word": "related",
                        "confidence": "0.79"
                    },
                    {
                        "start_time": "47.89",
                        "end_time": "48.44",
                        "word": "jobs",
                        "confidence": "0.98"
                    },
                    {
                        "start_time": "48.44",
                        "end_time": "48.90",
                        "word": "compared",
                        "confidence": "0.96"
                    },
                    {
                        "start_time": "48.90",
                        "end_time": "48.96",
                        "word": "to",
                        "confidence": "0.17"
                    },
                    {
                        "start_time": "48.96",
                        "end_time": "49.08",
                        "word": "new",
                        "confidence": "0.97"
                    },
                    {
                        "start_time": "49.08",
                        "end_time": "49.37",
                        "word": "york",
                        "confidence": "0.98"
                    },
                    {
                        "start_time": "49.37",
                        "end_time": "49.49",
                        "word": "and",
                        "confidence": "0.92"
                    },
                    {
                        "start_time": "49.49",
                        "end_time": "49.83",
                        "word": "la",
                        "confidence": "0.56"
                    }
                ]
            }
        ]
    },