


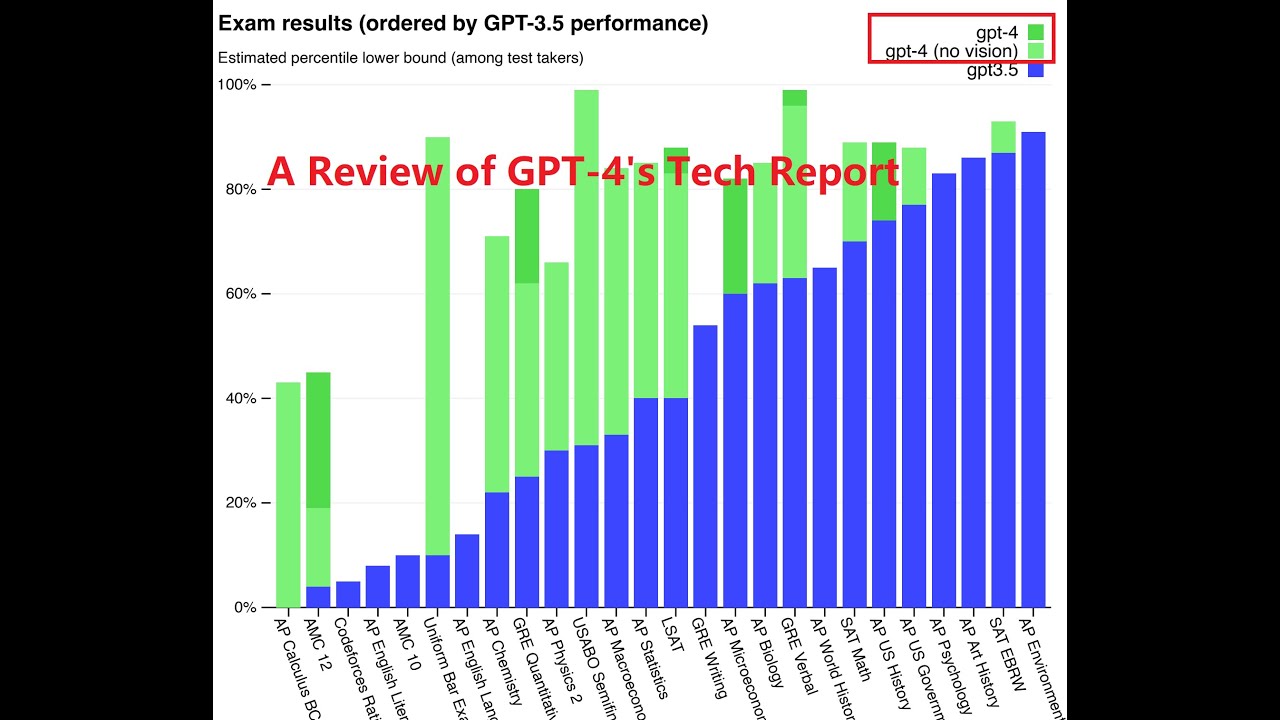
GPT-4의 기술 보고서 리뷰 (한눈에 보는 GPT-4)
GPT-4의 기술 보고서는 아키텍처 세부사항이 부족하고 능력 주장이 많기로 악명높으며, 이는 명확한 리뷰를 그 위에 구축하는 모든 사람을 위해 필수 읽기로 만듭니다.

[Olewave의 리뷰] AudioLM: 오디오 생성을 위한 언어 모델링 접근
AudioLM은 많은 사람들에게 오디오 생성이 신호 처리보다는 언어 모델링처럼 보여야 한다고 확신시킨 논문입니다.
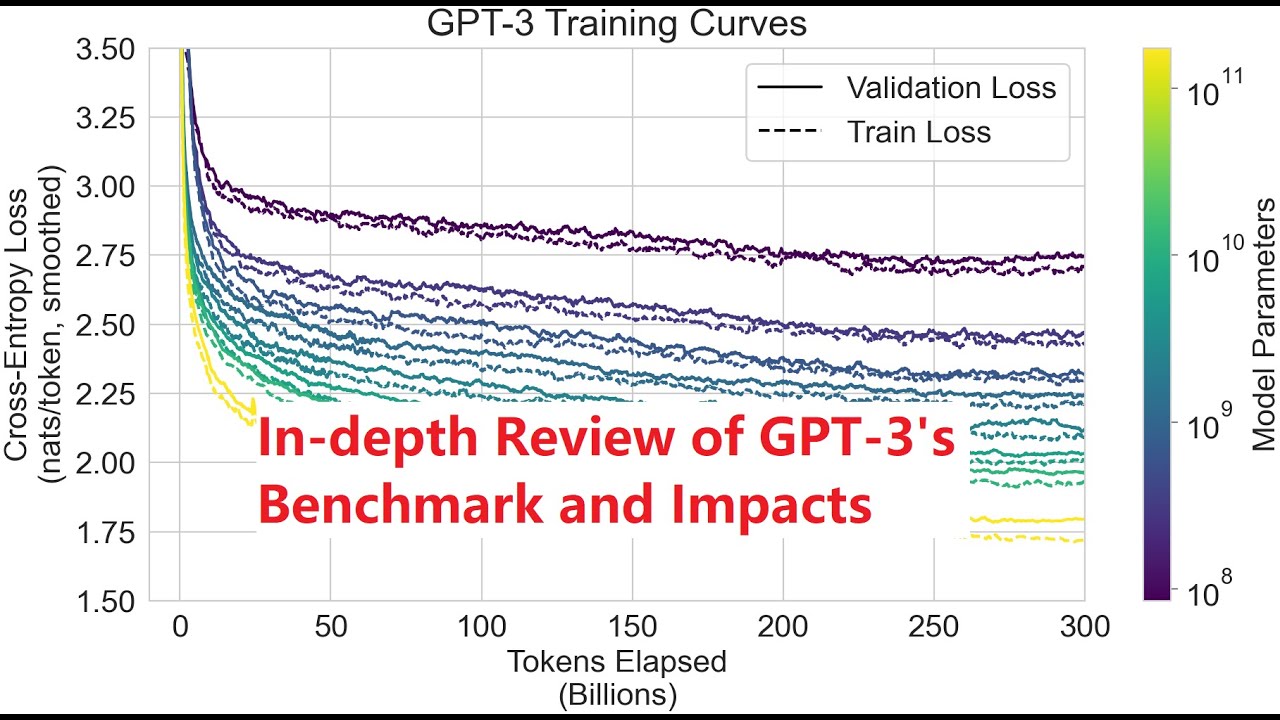
OpenAI의 GPT-3에 대한 심층 리뷰 : 언어 모델은 소수 샷 학습자입니다 (파트 3/3: 결과 및 나머지)
이 3부작 GPT-3 심층 분석의 최종 회차는 결과에 도달합니다: 1,750억 개의 파라미터를 벤치마크 스위트에 투입하고 미세 조정을 완전히 건너뛸 때 실제로 어떤 일이 발생하는지에 대해.

[10분] OpenAI의 Whisper API가 ChatGPT만큼 좋지 않은 이유 설명
Whisper는 큰 성공을 거두었지만, GPT-3이 NLP를 재편했던 방식으로 ASR을 재편하지는 못했습니다. 이 10분짜리 리뷰는 그 이유가 논문 자체에 내재되어 있다고 주장합니다.

OpenAI의 GPT-3에 대한 심층 검토: 언어 모델은 Few-Shot 학습자입니다 (파트 2/3: 결과)
이 GPT-3 심층 분석의 2부는 설정을 넘어 실제로 사람들이 NLP를 재생각하게 한 결과로 이동합니다.
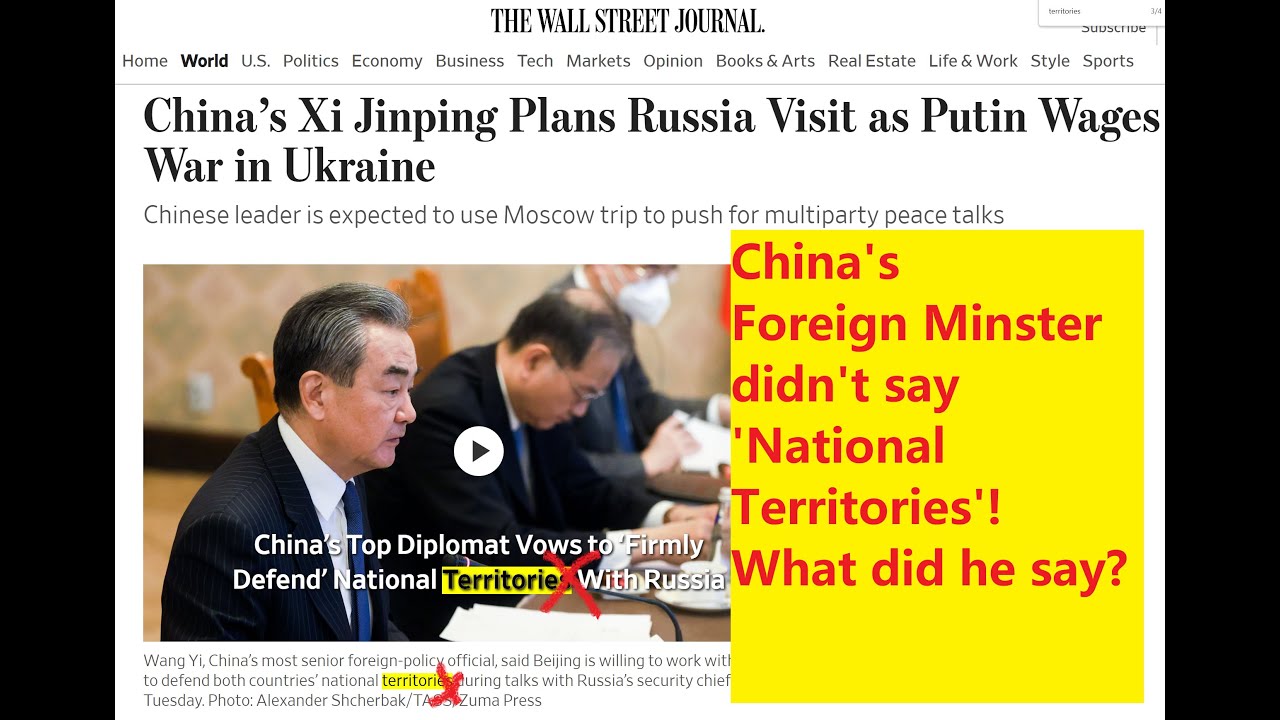
WSJ가 중국 외교부장의 연설 번역에서 실수를 저질렀습니다. 외교관은 무엇을 말했을까요?
기계 번역과 인간 번역 오류는 월스트리트 저널의 첫 페이지에 나타나고 지정학적 서사를 재편할 때 언어 애호가의 호기심 이상입니다.
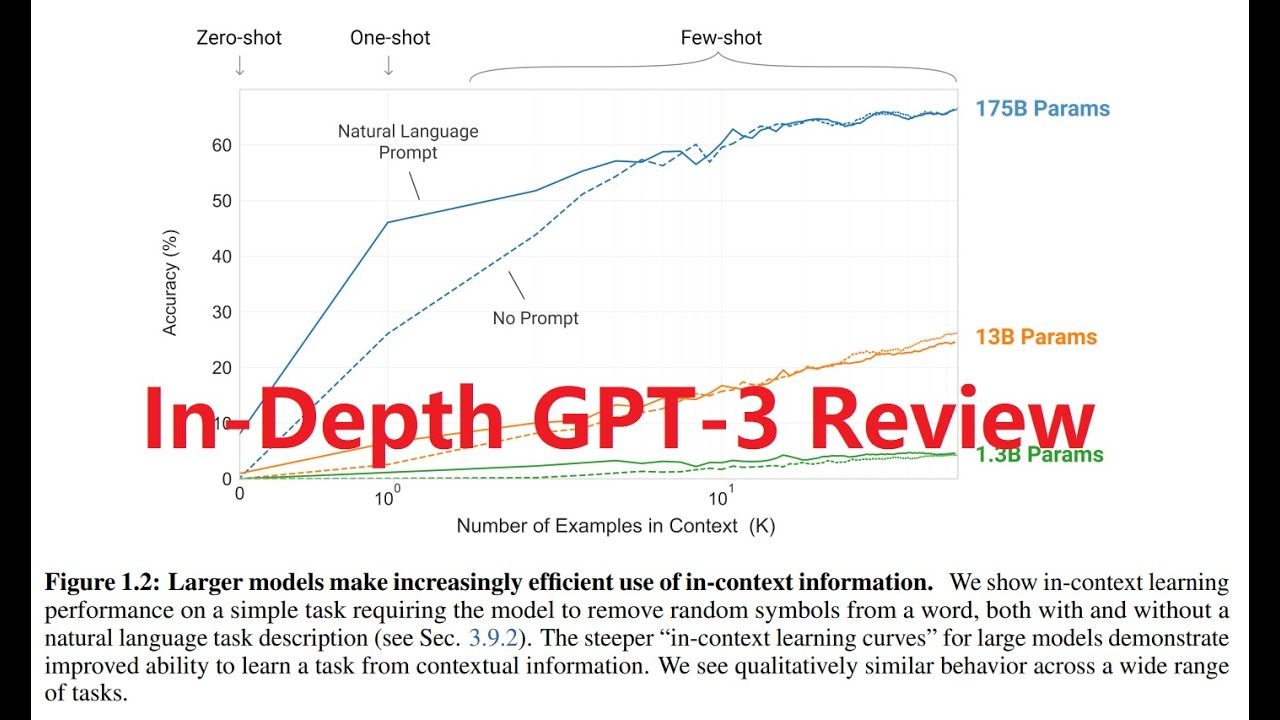
OpenAI의 GPT-3에 대한 심층 검토: 언어 모델은 Few-Shot 학습자입니다 (파트 1/3: 소개 & 접근)
이 세 부분 GPT-3 검토의 첫 번째 부분은 규모를 연구 베팅에서 업계 복음으로 바꾼 논문을 설정합니다.
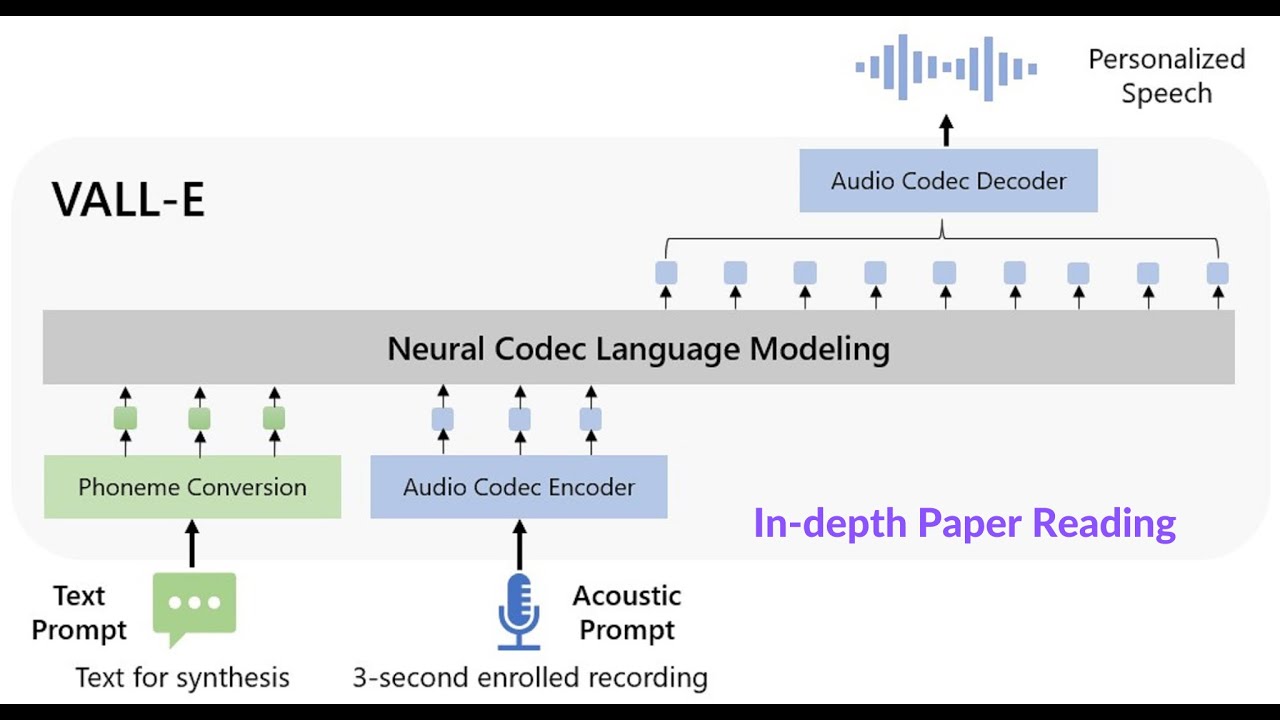
VALL-E의 심층 리뷰: 신경 코덱 언어 모델이 영샷 텍스트 음성 합성기
3초 참고 클립으로부터의 영샷 TTS는 VALL-E가 출시될 때까지 불가능해 보였지만, 이 심층 리뷰는 Microsoft가 정확히 어떻게 이를 달성했는지를 상세히 설명합니다.

3분 안에 Microsoft의 VALL-E 이해하기 (최고 성능 영샷 TTS)
VALL-E는 TTS가 신호 회귀처럼 보이기를 멈추고 언어 모델링처럼 보이기 시작한 순간이며, 이 빠른 설명은 당신을 신속하게 이해하도록 도와줍니다.

ChatGPT/ChatGPT Plus/InstructGPT: 인간 피드백으로 지시를 따르도록 언어 모델 훈련
ChatGPT 제품 뒤에는 InstructGPT 논문이 있으며, 이 상세 리뷰는 원시 GPT-3을 사람들이 실제로 대화하고 싶어 하는 것으로 변환한 파이프라인을 자세히 분석합니다.

3분 안에 ChatGPT/ChatGPT Plus가 어떻게 작동하는지 설명
ChatGPT는 외부에서는 마법처럼 보이지만, 어디를 봐야 하는지 알면 레시피는 잘 문서화되어 있으며, 이 3분 설명은 핵심 아이디어를 요약합니다.

[Olewave's Review] CLIP (3/3): 자연어 감독으로부터의 전이 가능한 시각 모델 학습
이 CLIP 검토의 마지막 부분은 결과 섹션에 도달하며, 여기서 OpenAI의 대조적 이미지-텍스트 모델이 흥미로운 아이디어에서 전체 멀티모달 스택의 기초 계층 기본 요소로 전환되었습니다.

[Olewave's Review] CLIP (2/3): 자연어 감독으로부터의 전이 가능한 시각 모델 학습
OpenAI의 CLIP은 고정 레이블 세트를 버리고 대신 인터넷에서 수집한 4억 개의 (이미지, 텍스트) 쌍으로 훈련함으로써 컴퓨터 비전의 스크립트를 뒤집었습니다.

[Olewave's Review] CLIP (1/3): 자연어 감독으로부터의 전이 가능한 시각 모델 학습
BLIP, LLaVA, 또는 가치 있는 음성-LLM이 있기 전에 CLIP이 있었으며, 이것이 이야기가 시작되는 곳입니다.

[Olewave's Review] 합성 E2E 모델을 사용한 SLU의 토큰 수준 시퀀스 레이블링
End-to-end SLU가 주목받고 있지만, 시퀀스 레이블링을 시퀀스 예측으로 취급하면 수십 년에 걸친 잘 이해된 토큰 수준 태깅 메커니즘이 조용히 버려집니다.

[Olewave의 리뷰] Branchformer: Parallel MLP-Attention Architectures, and E-Branchformer
Conformer는 수년간 최고의 ASR 인코더였지만, Branchformer와 그 후속작인 E-Branchformer는 순차적 conv-plus-attention이 유일한 경로가 아니라는 설득력 있는 주장을 제시합니다.
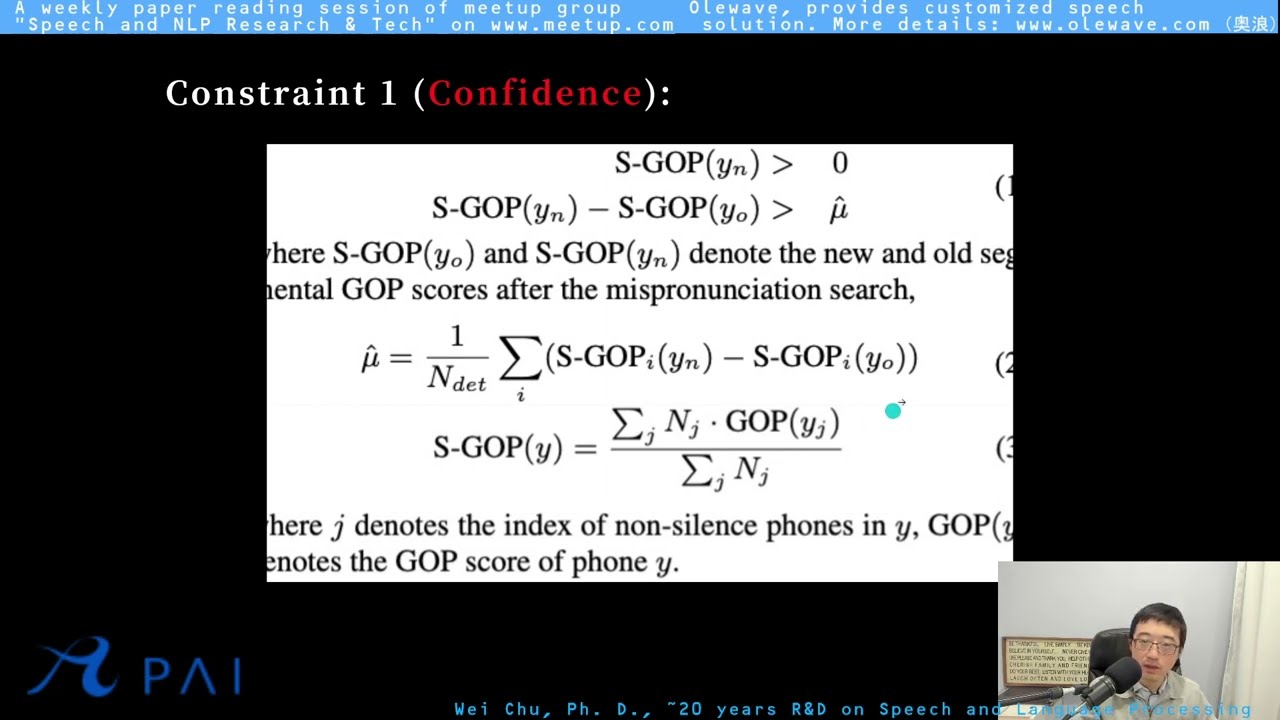
Non Collision Mispronunciation Addition (NCMA) for 사투리 ASR
사투리와 비원어민 음성은 발음 사전을 파괴하여 음성 모델 정렬을 조용히 오염시키는데, 이 Interspeech 2021 작업은 기만적으로 단순한 질문을 던집니다: 우리가 탐지된 오발음을 단순히 사전에 추가하면

[Olewave의 리뷰] OpenAI의 Whisper ASR: 대규모 약한 지도를 통한 강건한 음성 인식
OpenAI가 Whisper를 출시했을 때, ASR 커뮤니티는 68만 시간의 다국어, 다중 작업, 웹 크롤링 오디오로 훈련되어 사투리, 배경 소음, 기술 용어 전반에 걸쳐

One-Edit-Distance FSA/Network-based (OEDN)를 이용한 오발음 탐지 및 사투리 ASR
비원어민 음성 모델링은 닭과 계란 문제를 가지고 있습니다: 나쁜 음성 정렬은 나쁜 모델을 만들고, 나쁜 모델은 나쁜 정렬을 만듭니다.

Olewave의 RNN-T 설명 중 가장 상세함: Sequence Transduction with Recurrent Neural Networks
Alex Graves의 RNN-T 논문은 오늘날 출시되는 거의 모든 스트리밍 ASR 시스템의 조용한 조상이며, Google의 온디바이스 인식기에서부터 NeMo, ESPnet 등의 수많은 오픈소스 트랜스듀서 스택에 이르기까지입니다.
Google이 AI 봇이 센티언트라고 말한 Blake Lemoine을 해고했나? LaMDA나 ChatGPT가 인간처럼 생각할까?
Google이 LaMDA가 센티언트가 되었다는 주장을 공개한 Blake Lemoine을 해고했을 때, 그 이야기는 바이럴이 되었지만, 근본적인 질문이 남았습니다: LaMDA와 ChatGPT와 같은 대규모 언어 모델이 실제로 생각을

[Olewave의 롱 리뷰] 음성 인식을 위한 신경 트랜스듀서의 효율적인 훈련
신경 트랜스듀서는 스트리밍 ASR의 주력이지만, 효율적으로 훈련하는 것은 유명하게 고통스럽습니다: RNN-T 손실은 시퀀스 길이에서 3제곱 메모리를 가지며, 정렬 격자는 긴 발화에서 폭발하고, 단일-

Boris Johnson의 흥망 - 마이크의 분석
정치 뉴스는 보통 음성 AI 엔지니어가 금요일 오후에 큐에 올려놓는 것이 아니지만, Boris Johnson의 사임 발표는 일련의 스캔들에 대한 정당의 반란으로 마이크 뱅크 앞에서 전달되었습니다

[Olewave의 장편 리뷰] Xception: 깊이별 분리형 컨볼루션을 이용한 딥러닝
Xception은 Inception 가설을 논리적 극단까지 밀어붙이고 채널 간 및 공간적 상관관계를 완전히 분리된 연산으로 밀어붙였으며, 이로 인해 인기를 얻은 깊이별 분리형 컨볼루션은 이제 모든 곳에 나타난다

[Olewave의 단편 리뷰] Xception: 깊이별 분리형 컨볼루션을 이용한 딥러닝
Xception의 핵심 아이디어만 원하고 장편 리뷰의 깊은 내용은 원하지 않는다면, 이 단편 리뷰가 간단한 버전입니다.

중국의 항공모함 Fujian 003의 위상배열 레이더와 음성 빔포밍의 연결
중국의 최신 항공모함 Fujian 003에 탑재된 위상배열 레이더와 스마트 스피커가 시끄러운 방에서 당신의 말을 들을 수 있게 하는 마이크 어레이는 실제로 같은 기본 수학을 공유합니다.

iOS 16의 새로운 받아쓰기 기능은 어떻게 작동할까요? Apple의 비결을 음성 연구원이 밝혀줍니다!
Apple의 iOS 16 받아쓰기는 완전히 기기에서 실행되며, 이 단일 설계 선택은 지연 시간, 개인정보 보호, 그리고 휴대폰에서 실행 가능한 ASR 아키텍처의 종류에 대한 연쇄적 영향을 미칩니다.

[장문 리뷰] Conformer: 음성 인식을 위한 Convolution-augmented Transformer
Conformer는 end-to-end ASR을 조용히 장악한 모델이며, 모든 Transformer 블록에 convolution 모듈을 추가하는 그 방식은 단순하지만 놀랍게도 잘 작동하는 아이디어 중 하나입니다.

[단문 리뷰] Conformer: 음성 인식을 위한 Convolution-augmented Transformer
Conformer는 거의 단순한 작업을 통해 ASR 세계를 휩쓸었습니다: 각 Transformer 블록에 convolution 모듈을 붙여 모델이 전역 컨텍스트와 로컬 음향 세부 정보를 한 번에 포착할 수 있도록 했습니다.