
OpenAI WhisperからあなたのASRサービス自社へ:名前エンティティ&ドメイン固有用語の認識
Whisperはそのままで印象的ですが、実際に本番環境にデプロイした人なら誰もが知っているとおり、固有名詞、製品名、医療用語、法的専門用語、およびドメイン語彙の長い尾部全体で失敗します

ICASSP 2024でのOlewave
私たちはソウルで開催されたIEEE ICASSP 2024のパトロンおよび展示者でした。創業者兼CEOのWei Chuは、野生データやウェブから取得したデータから音声モデルを訓練することについてのスポットライトトークを行いました。

変分オートエンコーダ (VAE) と再パラメータ化トリック - 古典的生成モデルの再検討
拡散の前に、正規化フローの前に、潜在拡散モデルがあらゆる本格的な生成スタックにVAEエンコーダを静かに組み込む前に、KingmaとWellingの2013年論文がありました。それは変分オートエンコーダを導入していました

Microsoft+OpenAI、Google、Meta、NvidiaのオープンソースLargeスピーチモデルのASRレビュー
あらゆる主要なAIラボは現在、ASR向けのオープンソースLargeスピーチモデルをリリースしており、本番環境向けに適切なものを選択することが実際の課題となりました。
Tycho: 高ROIの自社音声関連サービス (ASR/TTS/翻訳) を構築するためのツールキット:概要
自社のASR、TTS、または音声翻訳サービスが必要なほとんどのチームは、同じ厄介な選択に直面しています。ESPnet、NeMo、k2、HuggingFaceの断片を接ぎ合わせるか、すべてをクラウドAPIに任せて1分ごとに支払うかです。

OpenAIのWhisperモデルから自社ASRサービスまで:後処理と言語モデリング
生のWhisper出力は素晴らしいものですが、実際のユーザーにデプロイした経験がある人なら、デモトランスクリプトと下流システムが実際に利用できるもの間のギャップを知っています。
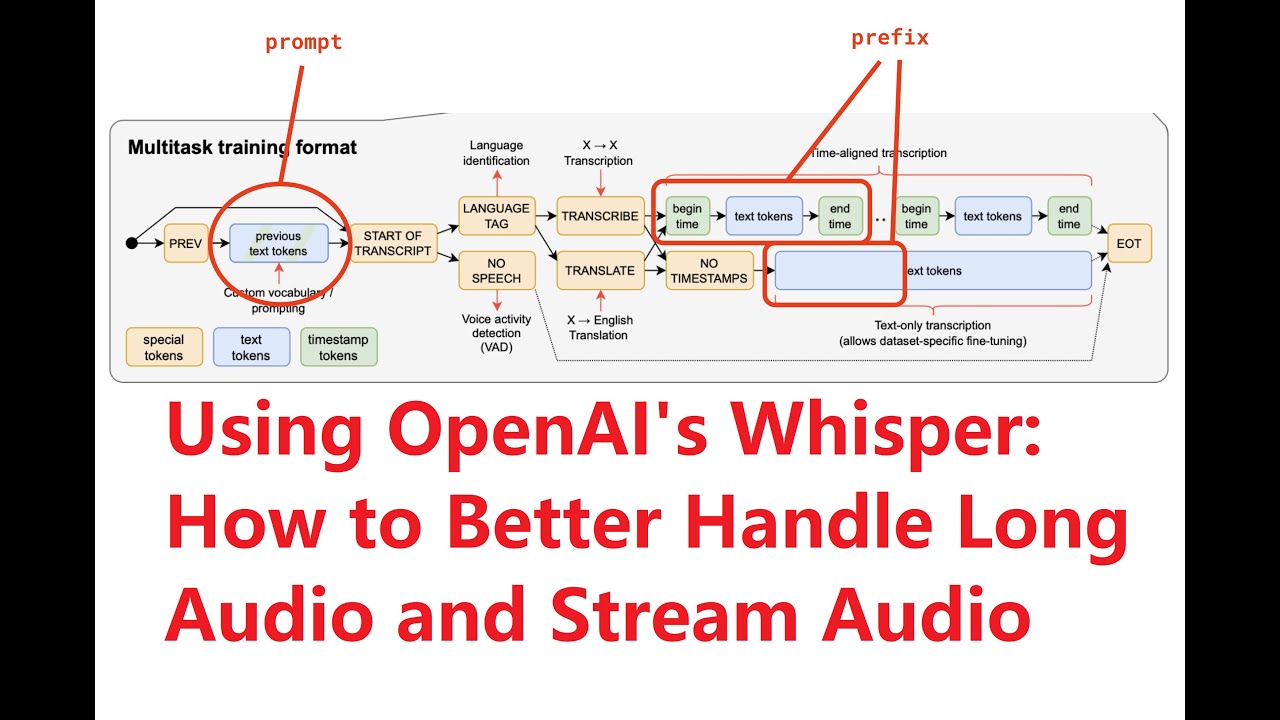
OpenAIのWhisperモデルから自社ASRサービスまで:長いオーディオとストリーミング(パート3)
Whisperは30秒のチャンクで訓練されており、2時間のポッドキャストをフィードするか、ライブキャプショニングパイプラインにワイアリングしようとする瞬間に見せています。
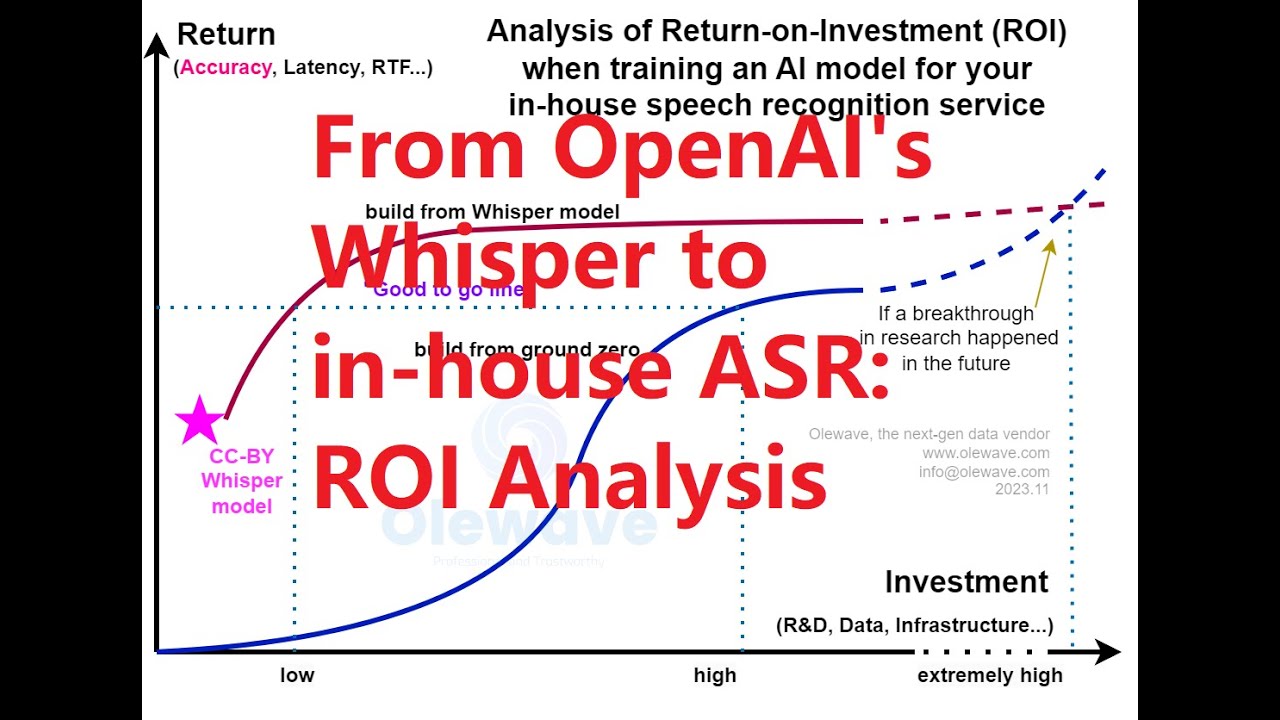
OpenAIのWhisperモデルから自社ASRサービスまで:ROI(投資対効果)(パート2)
ASRのビルド対バイの質問は、通常、精度と利便性としてフレーミングされていますが、実際の決定要因は製品のライフタイム全体にわたるROIです。
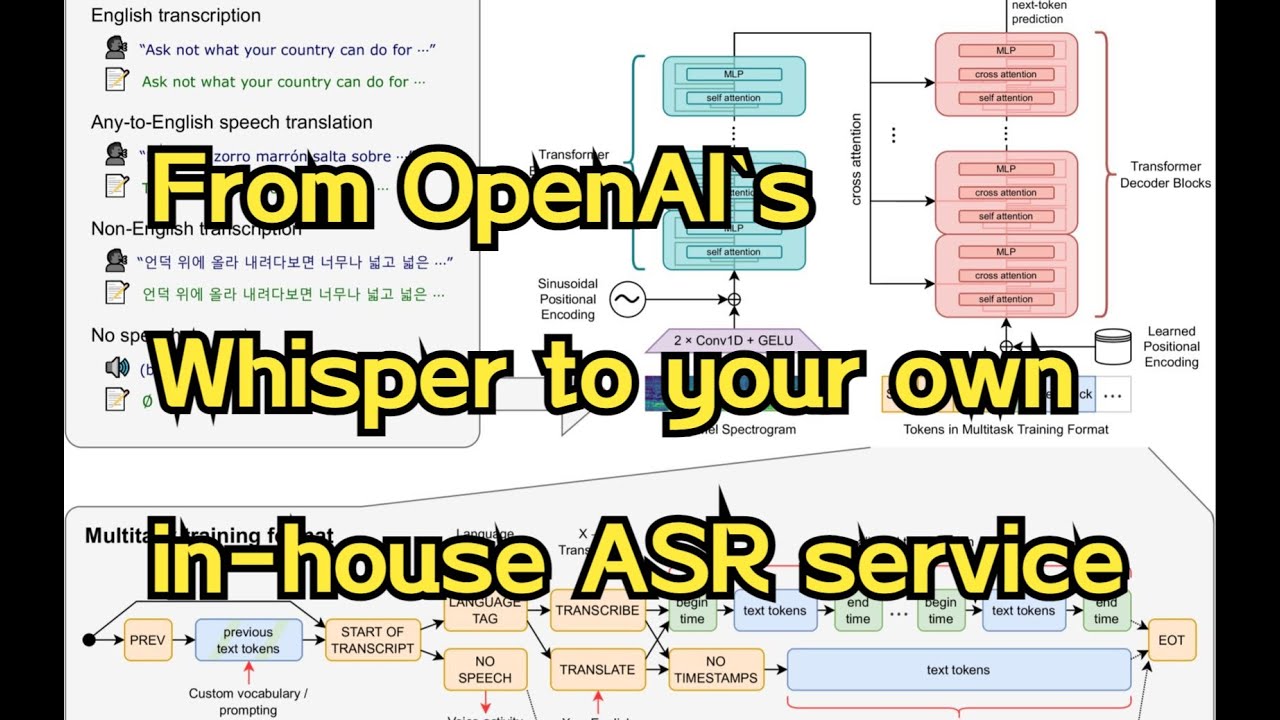
OpenAIのWhisperモデルから自社ASRサービスまで:概要(パート1)
OpenAIがWhisperをオープンソース化したとき、それは静かに自社ASRサービスが何のようなものであるかのベースラインをリセットしました。

OpenAI Whisperが生成した単語タイムスタンプが正確でない理由は?再度正確にする方法は?
Whisperに単語タイムスタンプを要求すると数字が返ってくる — しかし、実際の音声にカラオケ、キャプション、またはダビング用にそれを並べてみようとしたことがあれば、ドリフト、間違った境界へのスナップ、そして時々
音声生成AI:Meta AIによるVoiceBox(フローマッチングとニューラルODEも含む)
何年間も、音声生成はスケールと汎用性の両面でテキストと画像生成に遅れていた — すべてのタスクは独自の専用モデルを取得しました。

I-JEPA:Yann LeCunによるコンピュータビジョン用の最初の「ワールドモデル」
Yann LeCunは何年も、生成的事前訓練が世界を理解する機械を構築するための間違った賭けであると主張してきました。
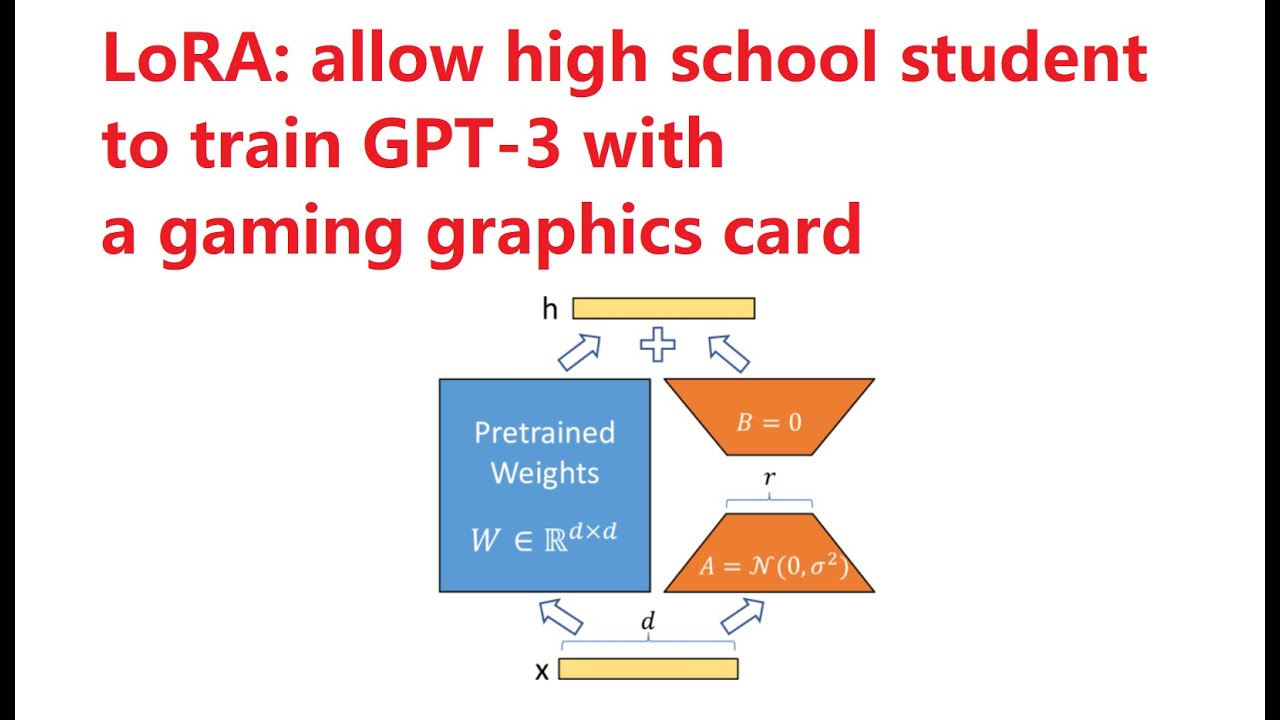
LoRA:高校生がゲーミング用グラフィックスカードでLarge Language Model(GPT-3)を訓練できるようにする
175Bパラメータ数のGPT-3の完全な微調整は、ほぼ誰もが開始できない — ストレージだけでそれを除外し、GPUはおろか。

SpeechT5のレビュー: GoogleのT5をSpeech(ASR, TTS, SID, ...)タスクに導入
T5は単一のエンコーダ-デコーダ事前学習レシピのもとでテキスト間のタスクを統一し、NLPの主要なツールとなりました。
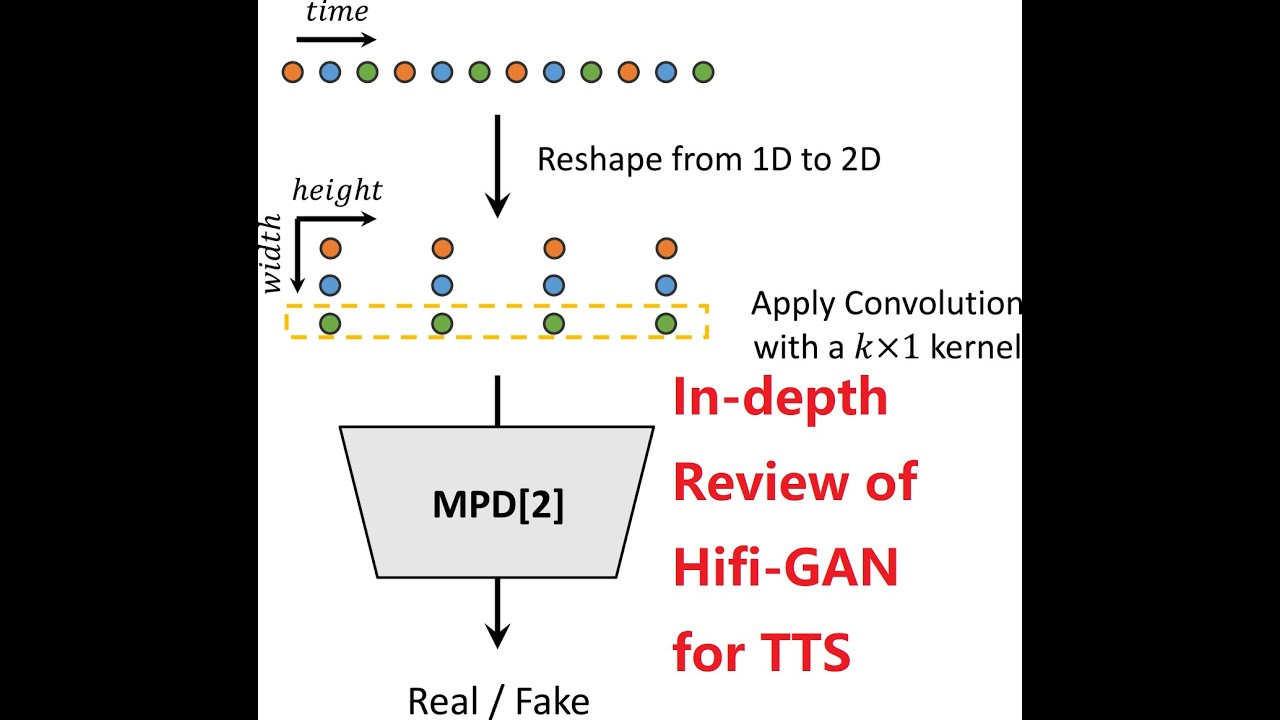
HiFi-GANのレビュー: 効率的で高忠実度の音声合成のための生成的敵対的ネットワーク
長い間、ニューラルボコーダーはあなたに選択を強制しました:WaveNetのような自己回帰モデルは素晴らしいオーディオを提供しましたが、非常に遅かった一方で、GANベースの波形ジェネレーターは高速でしたが、目立って低品質でした。

GoogleのSoundStreamの詳細レビュー: エンドツーエンドニューラルオーディオコデック
ニューラルコデックは静かに最新の生成的オーディオの基盤層となり、SoundStreamはそのプロセスを開始した論文の1つです。
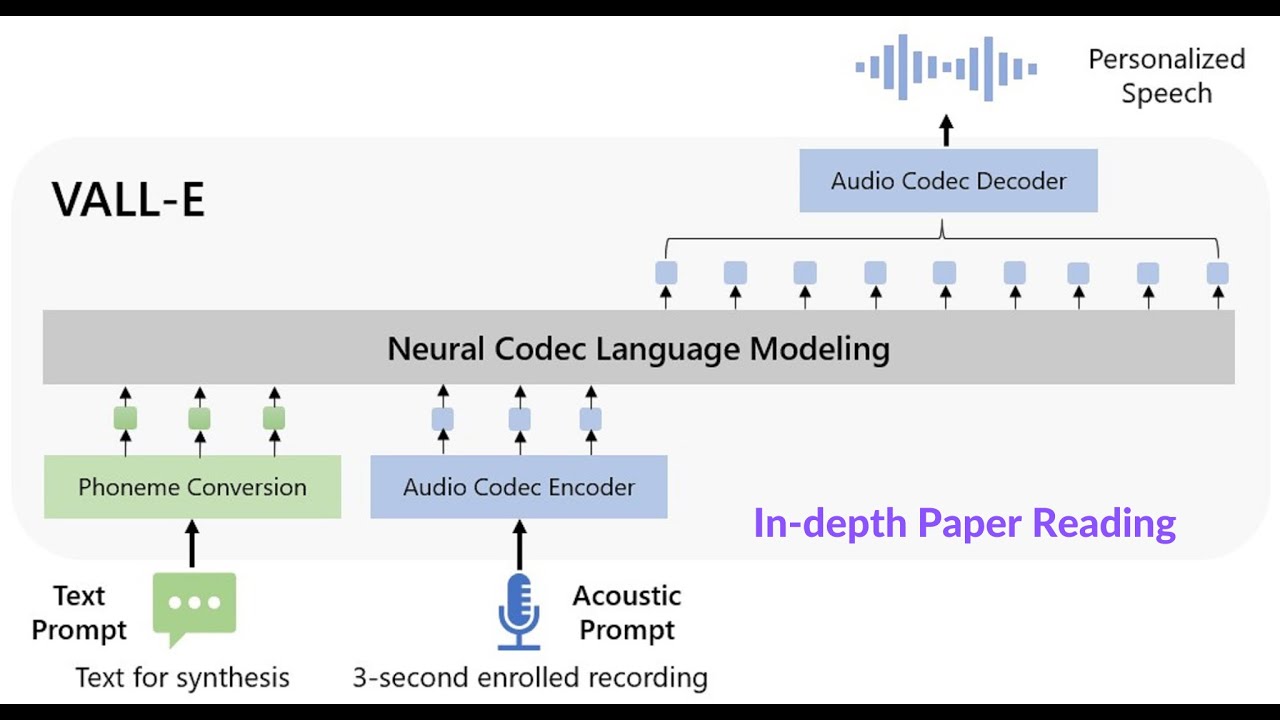
VALL-Eの詳細なレビュー:ニューラルコーデック言語モデルがゼロショットテキスト音声合成器である
3秒間のリファレンスクリップからのゼロショットTTSは実現不可能に思えましたが、VALL-Eがリリースされるまで、この詳細なレビューはMicrosoftがどのようにそれを実現したかを正確に解説しています。
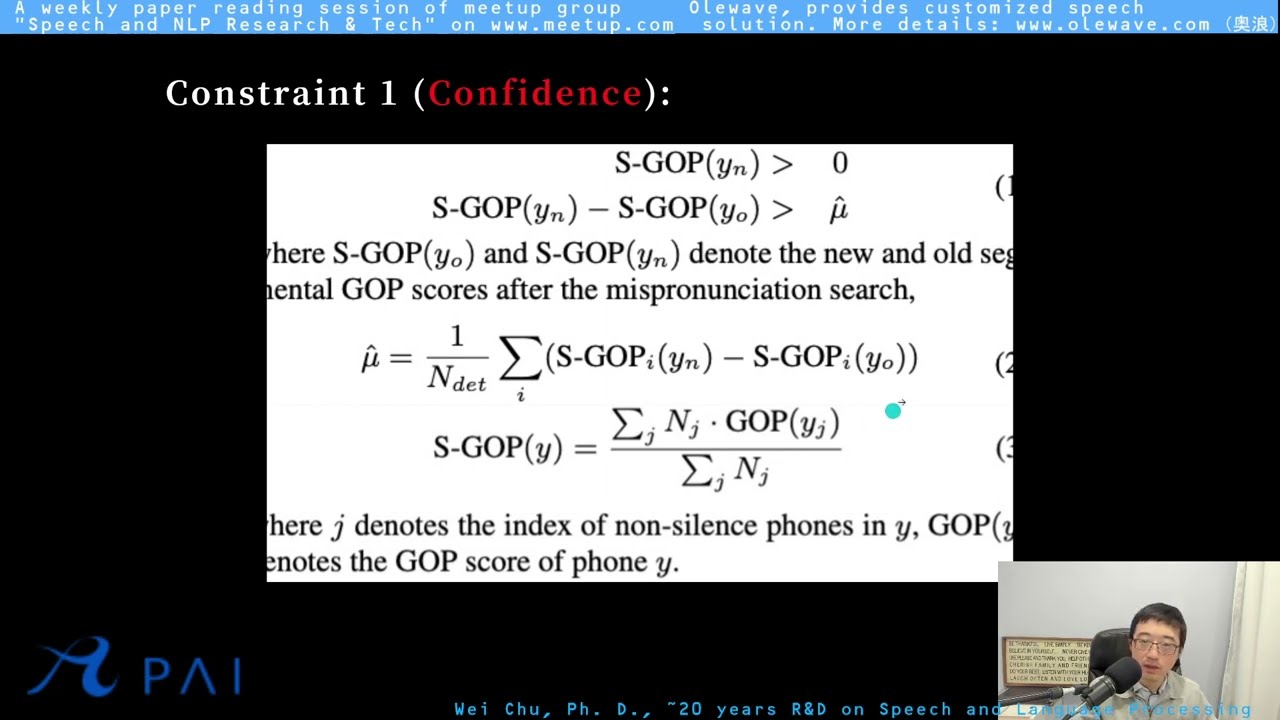
衝突なし誤発音追加(NCMA):アクセント付きASR向け
アクセント付きおよび非ネイティブ音声は発音辞書を破壊する方法で、あなたの音響モデルアライメントに静かに毒を注入します。このInterspeech 2021の研究は一見単純な質問を提起します:検出された

ワン編集距離FSA/ネットワークベース(OEDN)による誤発音検出とアクセント付きASR
非ネイティブ音響モデリングはニワトリと卵の問題を持っています:悪い音素アライメントは悪いモデルを生成し、悪いモデルは悪いアライメントを生成します。

[Olewnaveのショートレビュー] Xception: 深層学習による深さ方向分離可能畳み込み
ロングフォームの深掘りなしでコアのXceptionアイデアだけが必要でしたら、このショートレビューはエクスプレスバージョンです。

【短編レビュー】Conformer:音声認識のための畳み込み拡張Transformer
Conformerはほぼ地味なアプローチでASR界を席巻しました:各Transformerブロックに畳み込みモジュールを統合することで、モデルはグローバルコンテキストとローカル音響特性の両方を一度にキャプチャします。

博士がコンピュータを使ってズルして、2022年の大学入学試験の数学圧軸大問を解く
研究レベルのコンピュータ代数ツールキットを2022年の中国ガオカオ数学の最難問に活用するとどうなるでしょう?

[ロング レビュー] Wav2Seq: 疑似言語を使用した音声テキスト変換エンコーダーデコーダーモデルの事前訓練
ほとんどの音声事前訓練はエンコーダー側に焦点を当てています。wav2vec、HuBERT、WavLMですが、系列対系列ASRは事前訓練されたデコーダーも必要です。


[ロングレビュー] 訓練データの重複排除により言語モデルが向上する
重複排除は退屈に聞こえるかもしれませんが、61語の単一文がC4内に60,000回以上出現すること、そのようなコーパスで訓練された言語モデルがユーザーに訓練セットテキストを不気味に
三つ子のようなロシアのフィギュアスケーター:Kullback-Leiblerダイバージェンスは彼らの違いを見分けるのに使用できますか?
スピーカー適応は、エンコーダーの獲得した音響表現を損なわないようにシーケンス・ツー・シーケンスモデルを適応させようとするまでは、解決されたように聞こえるASR問題の1つです。
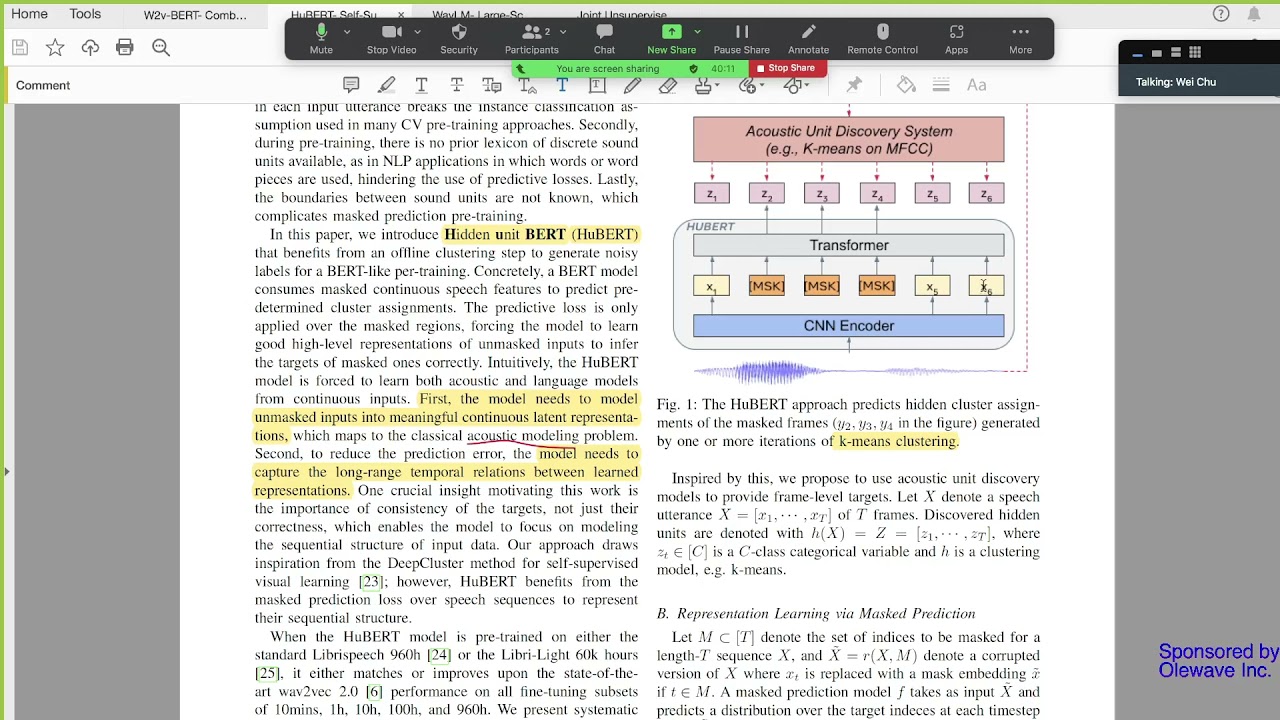
HuBERT: 隠れユニットのマスク予測による自己教師あり音声表現学習
wav2vec 2.0 はコントラスティブ自己教師あり学習でゲームを変えましたが、HuBERT はより鋭い質問を投げかけました。コントラスティブなトリックをスキップして、単に音声に対して BERT スタイルのマスク予測を行ったらどうでしょうか?

W2v-BERT: コントラスティブ学習とマスク言語モデリングを組み合わせた自己教師あり学習
音声事前学習のためのコントラスティブ学習とマスク言語モデリング、どちらか一方を選ぶ必要があるでしょうか?両方を同じネットワークに接続できるなら、その必要はありません。


多言語 ASR のための共同無教師学習と教師あり学習
事前学習-ファイン チューニングは多言語 ASR のデフォルト レシピになってきましたが、改善の余地があります。2 つのステージは損失を共有していないため、教師あり段階により有用な自己教師あり構造が静かに洗い流される可能性があります。