

Olewaveの音声データクリーニングパイプラインが効果的でユニークな理由
OlewaveのOlignパイプラインが、生の音声を、検証済みの書き起こし、単語レベルのタイムスタンプ、信頼度スコアを備えた本番利用可能なASR/TTS学習データに変える仕組みを紹介します。人手によるラベル付けは不要です。

Olewaveの最先端かつ高いカスタマイズ性を備えた音声データクリーニングパイプラインは、音声データ収集パイプラインとシームレスに統合されています。両者を合わせたものがOlewaveの音声データキュレーションパイプラインです。このエンドツーエンドのシステムは、高品質で一貫性があり、コスト効率の高い音声データセットを大規模に提供できるよう、入念に設計されています。幅広い下流アプリケーションに合わせて調整されています。さらに、当社のパイプラインでキュレーションした大規模でコスト効率の高い音声データセットも提供しています。複数の言語に対応し、さまざまなトピックをカバーしています。
下の図は、当社の音声データクリーニングパイプラインの効率的なワークフローを示しています。生の非構造化音声データを、整った実用的なデータセットに変換できます。
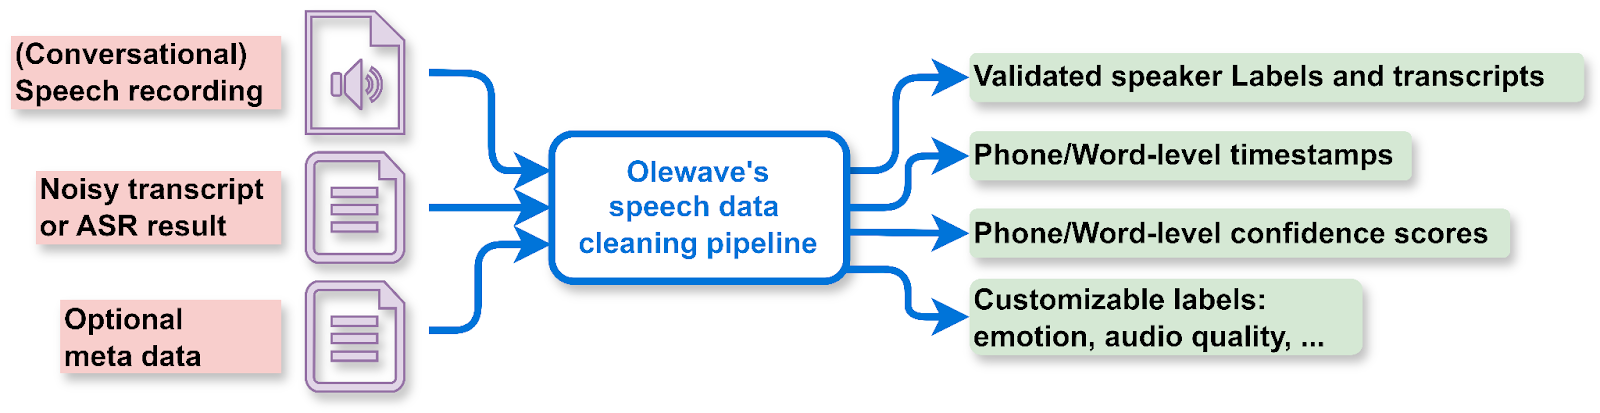
当社のパイプラインには、いくつかの利点があります。
- 有効性。Whisperやその他のオープンソースツールと比べて、検証済みの話者ラベルと書き起こし、正確な単語タイムスタンプ、自信過剰になりすぎない信頼度スコアを得られます。
- 堅牢性。即興の会話音声にも対応します。話者の重なりがある場面や、ASRの誤りを含む書き起こしも扱えます。
- 拡張性。任意のメタデータを活用でき、ラベルの信頼性を高めるために追加のモダリティを取り込む形へ拡張できます。また、Olewaveまたはお客様が独自に用意したさまざまなラベルタグ付けモデル(例えば、感情や意味など)を、プラグアンドプレイで組み込めます。
- 効率性。GPUリソースがほとんど、またはまったく必要ないため、高速に動作し、コストも抑えられます。
また、人間のアノテーターに自動音声認識(ASR)の結果を修正してもらいたい場合も、当社のパイプラインの出力によってラベリングコストを大幅に削減できます。その方法は2つあります。
- 正確なタイミング情報とともに単語を的確にハイライトします。アノテーターは、音声全体を繰り返し聞かなくても、ぼそぼそと話された区間や不明瞭な区間をすばやく見つけて確認できます。
- 中程度の信頼度スコアの単語に集中するよう、アノテーターを導きます。すべての単語を確認する手間を最小限に抑え、修正作業を効率化できます。
このように的を絞った情報を提供することで、当社のパイプラインは作業効率を高め、手作業を減らし、コスト効率の高いアノテーションワークフローを実現します。
以下は、パイプラインの出力を可視化した例です。話者ラベル、単語レベルのタイムスタンプ、信頼度スコアを示しています。
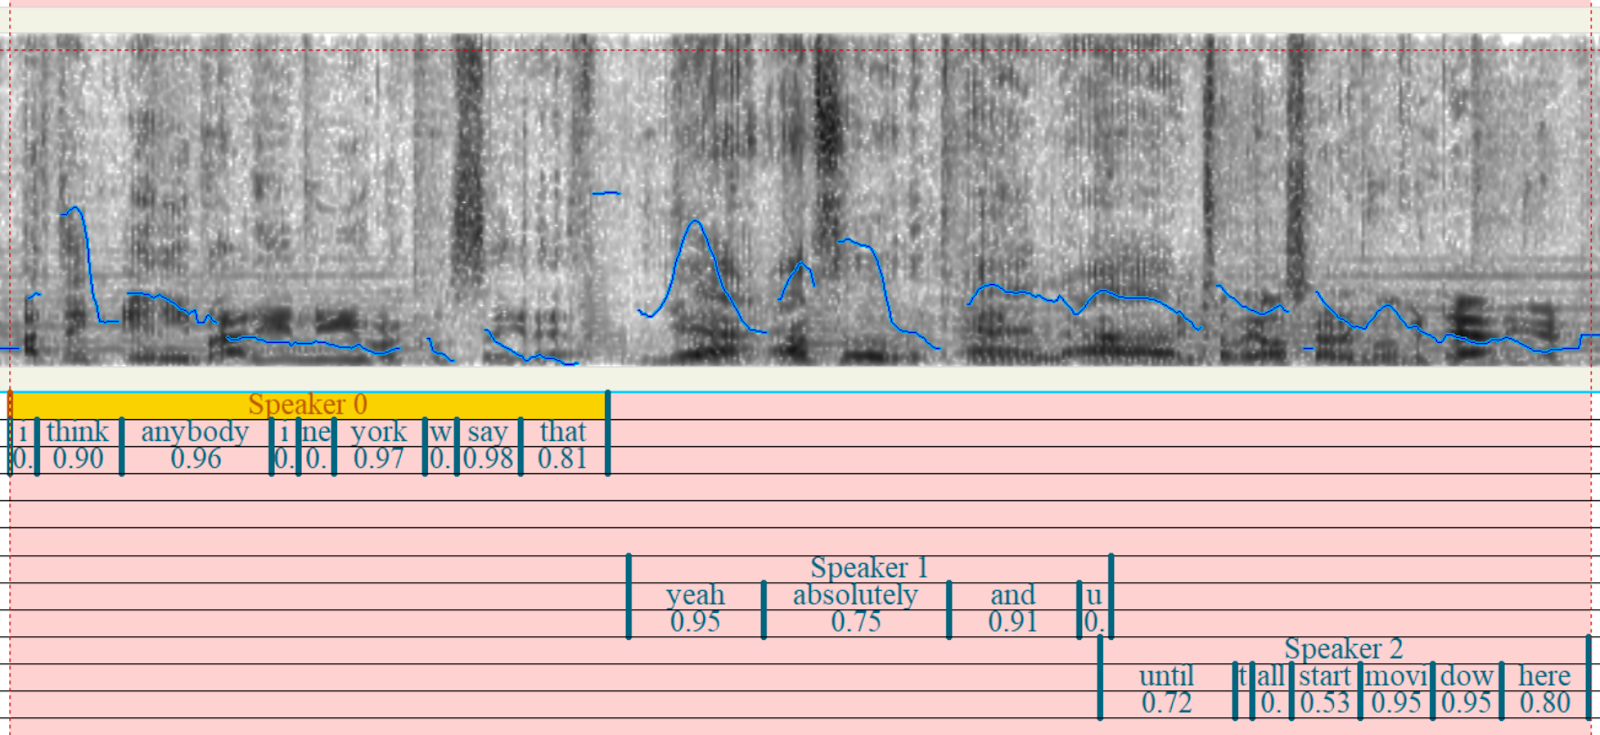
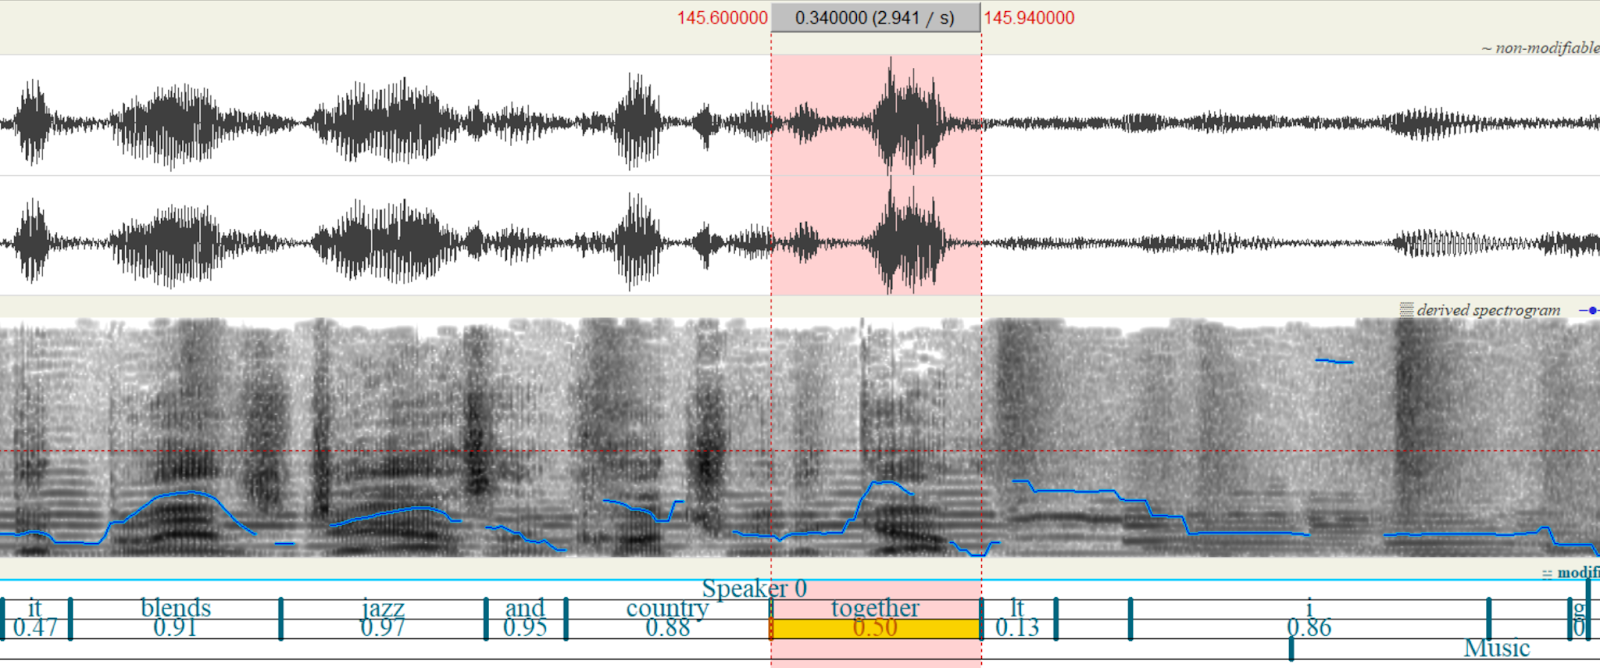
学術界でも産業界でも、大規模なエンドツーエンド(E2E)フレームワークと大規模なE2E ASRモデルには、それぞれ正確な単語レベルのタイムスタンプと信頼できる単語レベルの信頼度スコアを出力するうえで、本質的な限界があると広く認識されています。
こうした限界に対処するため、当社は非エンドツーエンドの音声テキストアライメント技術に関する深い専門知識を活かし、メタデータ情報を取り入れた高度な手順を開発しました。この手法で、書き起こしから発話されていない内容(例えば、フィラーワードや背景ノイズの書き起こし)を効果的に取り除けます。その結果、最終的な出力の精度と信頼性が高まります。
以下は、データパイプラインが出力する単語レベルのJSONの抜粋です。「speaker」フィールドは、この録音における話者のIDを示します。「start_time」と「end_time」フィールドは秒単位で、その話者が話している時間の範囲を示します。「block」フィールドには、同じ話者による1つまたは複数の連続した発話が入ります。各発話には、開始時刻、終了時刻、書き起こし、話者の重なりを示すフラグ、信頼度スコアがそれぞれ付いています。「overlap」フィールドが true の場合、現在のセグメントが隣接するセグメントと話者の重なりを持つことを意味します。信頼度スコアは0から1の範囲です。
{
        "speaker": 0,
        "start_time": "47.18",
        "end_time": "49.83",
        "block": [
            {
                "start_time": "47.18",
                "end_time": "49.83",
                "transcript": "music-related jobs compared to New York and LA.",
                "overlap": false,
                "word_details": [
                    {
                        "start_time": "47.18",
                        "end_time": "47.53",
                        "word": "music",
                        "confidence": "0.97"
                    },
                    {
                        "start_time": "47.53",
                        "end_time": "47.89",
                        "word": "related",
                        "confidence": "0.79"
                    },
                    {
                        "start_time": "47.89",
                        "end_time": "48.44",
                        "word": "jobs",
                        "confidence": "0.98"
                    },
                    {
                        "start_time": "48.44",
                        "end_time": "48.90",
                        "word": "compared",
                        "confidence": "0.96"
                    },
                    {
                        "start_time": "48.90",
                        "end_time": "48.96",
                        "word": "to",
                        "confidence": "0.17"
                    },
                    {
                        "start_time": "48.96",
                        "end_time": "49.08",
                        "word": "new",
                        "confidence": "0.97"
                    },
                    {
                        "start_time": "49.08",
                        "end_time": "49.37",
                        "word": "york",
                        "confidence": "0.98"
                    },
                    {
                        "start_time": "49.37",
                        "end_time": "49.49",
                        "word": "and",
                        "confidence": "0.92"
                    },
                    {
                        "start_time": "49.49",
                        "end_time": "49.83",
                        "word": "la",
                        "confidence": "0.56"
                    }
                ]
            }
        ]
    },