

ما الذي يجعل خط أنابيب تنظيف بيانات الكلام من Olewave فعالاً وفريداً من نوعه
كيف يحول خط معالجة Olign من Olewave الصوت الخام إلى بيانات تدريب ASR/TTS جاهزة للإنتاج، مع نصوص مفرغة تم التحقق منها وطوابع زمنية على مستوى الكلمة ودرجات ثقة، دون الحاجة إلى معلقين بشريين.

يتميز خط تنظيف بيانات الكلام من Olewave بأنه متطور وقابل للتخصيص بدرجة عالية. ويتكامل بسلاسة مع خط جمع بيانات الكلام الخاص بها، ويشكلان معًا خط تنسيق بيانات الكلام من Olewave. صُمم هذا النظام الشامل بعناية فائقة ليقدم مجموعات بيانات كلام عالية الجودة ومتسقة وفعالة من حيث التكلفة على نطاق واسع. وهي مصممة لتناسب طيفًا واسعًا من التطبيقات اللاحقة. كما نوفر مجموعات بيانات كلام واسعة النطاق وفعالة من حيث التكلفة جرى تنسيقها عبر خط المعالجة لدينا. وهي متاحة بلغات متعددة وتغطي مواضيع متنوعة.
يوضح الشكل أدناه سير العمل المبسط في خط تنظيف بيانات الكلام لدينا، ويبرز قدرته على تحويل بيانات الكلام الخام وغير المنظمة إلى مجموعات بيانات مصقولة وجاهزة للاستخدام الفعلي.
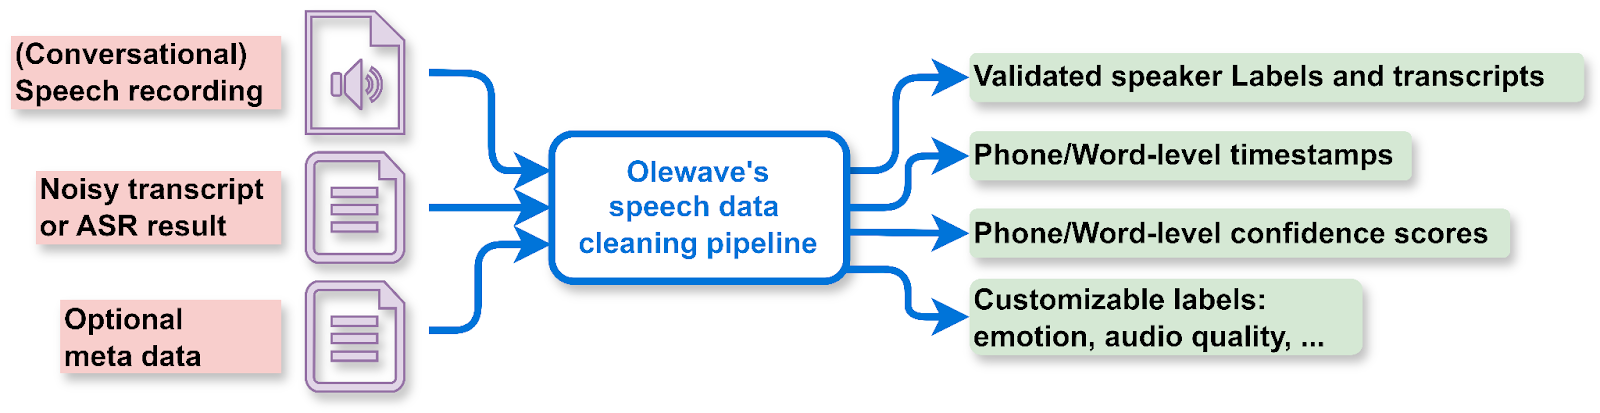
يقدم خط المعالجة لدينا عدة مزايا.
- الفعالية. ينتج تسميات متحدثين وتفريغات نصية تم التحقق منها، وطوابع زمنية دقيقة للكلمات، ودرجات ثقة غير مبالغ فيها، مقارنة مع Whisper وغيره من الأدوات مفتوحة المصدر.
- المتانة. يتعامل مع الكلام الحواري الارتجالي، بما في ذلك حالات تداخل المتحدثين والنصوص المفرغة التي تحتوي على أخطاء ASR.
- قابلية التوسع. يستفيد من البيانات الوصفية الاختيارية، ويمكن تطويره ليضم نمطًا إضافيًا من البيانات لزيادة موثوقية التسميات. كما يدعم خط المعالجة دمج نماذج وضع التسميات المتنوعة التي تقدمها Olewave أو يملكها العميل بأسلوب التوصيل والتشغيل (مثل المشاعر والدلالات، …).
- الكفاءة. يعمل بسرعة وبفعالية من حيث التكلفة، لأنه لا يتطلب موارد GPU أو يتطلب القليل منها.
وبالإضافة إلى ذلك، إذا كان هدفك أن يقوم معلقون بشريون بتنقيح نتائج التعرف التلقائي على الكلام (ASR)، فيمكن لمخرجات خط المعالجة لدينا أن تخفض تكاليف وضع التسميات بشكل ملحوظ بطريقتين.
- إبراز الكلمات بدقة مع معلومات توقيت صحيحة، مما يمكّن المعلقين من تحديد المقاطع المتمتمة أو غير الواضحة ومراجعتها بسرعة دون الاستماع المتكرر إلى الصوت بأكمله.
- توجيه المعلقين إلى التركيز على الكلمات ذات درجات الثقة المتوسطة، مما يقلل الحاجة إلى مراجعة كل كلمة ويبسط عملية التصحيح.
وبفضل هذه الرؤى الموجهة، يعزز خط المعالجة لدينا الكفاءة، ويقلل الجهد اليدوي، ويضمن سير عمل للتعليق التوضيحي أكثر فعالية من حيث التكلفة.
فيما يلي أمثلة مرئية لمخرجات خط المعالجة، تعرض تسمية المتحدث والطوابع الزمنية على مستوى الكلمة ودرجات الثقة.
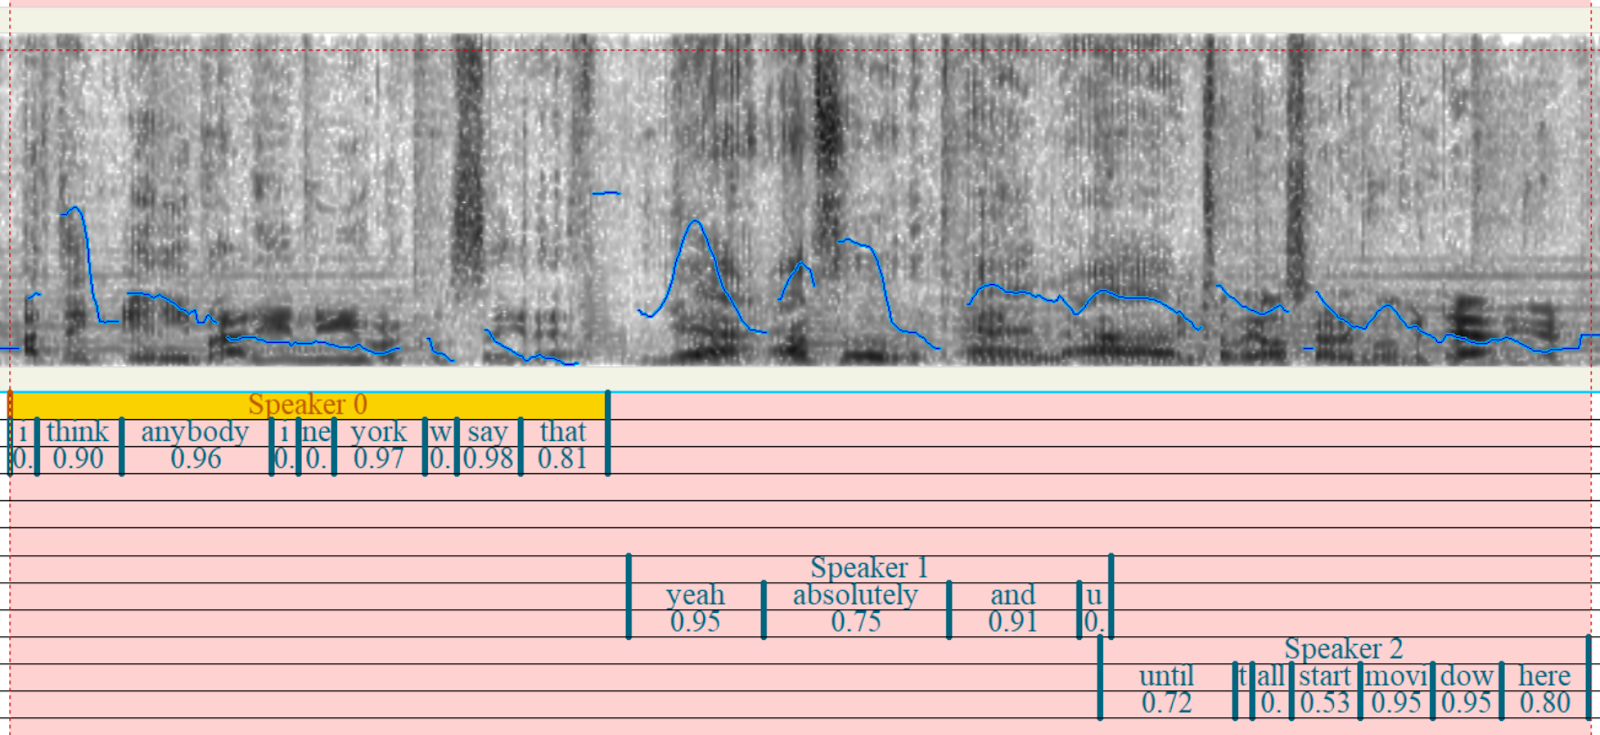
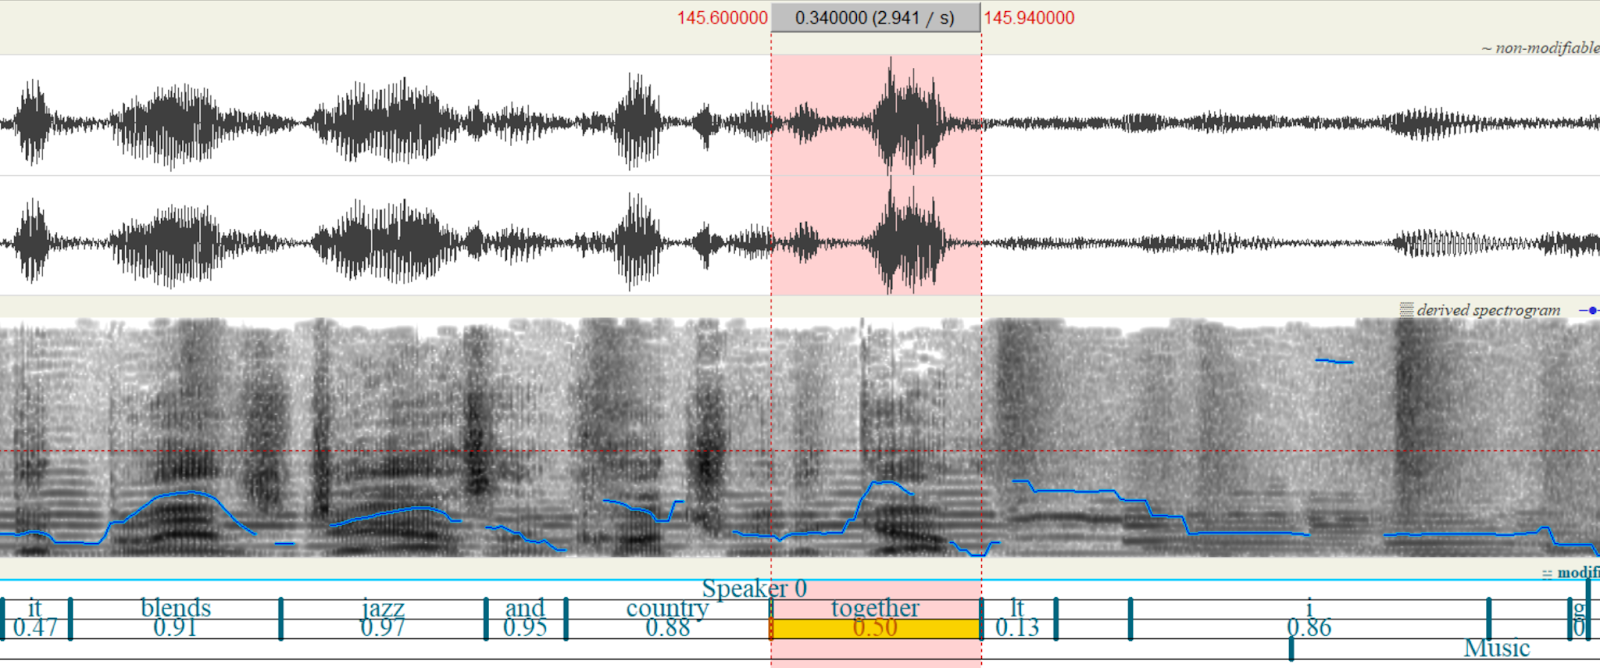
من المعروف على نطاق واسع في الأوساط الأكاديمية والصناعية أن أطر العمل من طرف إلى طرف (E2E) الكبيرة ونماذج ASR الكبيرة من نوع E2E لها قيود متأصلة عندما يتعلق الأمر بإنتاج طوابع زمنية دقيقة على مستوى الكلمة ودرجات ثقة موثوقة على مستوى الكلمة على التوالي.
ولمعالجة هذه القيود، نستفيد من خبرتنا العميقة في تقنيات محاذاة الكلام مع النص غير القائمة على نهج من طرف إلى طرف، وقد طورنا إجراءات متقدمة تدمج معلومات البيانات الوصفية. يتيح لنا هذا النهج تنظيف المحتوى غير المنطوق (مثل الكلمات الحشوية ونصوص ضوضاء الخلفية) من النصوص المفرغة بفعالية، مما يضمن دقة وموثوقية أعلى في المخرجات النهائية.
فيما يلي مقتطف من مخرجات json على مستوى الكلمة الصادرة عن خط معالجة البيانات. يشير الحقل 'speaker' إلى معرّف المتحدث في هذا التسجيل. الحقلان 'start_time' و'end_time' بالثواني، ويشيران إلى الفترة الزمنية التي يتحدث فيها المتحدث. يحتوي الحقل 'block' على عبارة منطوقة واحدة أو عدة عبارات منطوقة متتالية من المتحدث نفسه. لكل عبارة منطوقة وقت بدء ووقت انتهاء ونص مفرغ ومؤشر لتداخل المتحدثين ودرجة ثقة. عندما تكون قيمة الحقل 'overlap' هي true، فهذا يعني أن هناك تداخلًا بين المتحدثين في المقطع الحالي والمقاطع المجاورة. تتراوح درجة الثقة بين 0 و1.
{
        "speaker": 0,
        "start_time": "47.18",
        "end_time": "49.83",
        "block": [
            {
                "start_time": "47.18",
                "end_time": "49.83",
                "transcript": "music-related jobs compared to New York and LA.",
                "overlap": false,
                "word_details": [
                    {
                        "start_time": "47.18",
                        "end_time": "47.53",
                        "word": "music",
                        "confidence": "0.97"
                    },
                    {
                        "start_time": "47.53",
                        "end_time": "47.89",
                        "word": "related",
                        "confidence": "0.79"
                    },
                    {
                        "start_time": "47.89",
                        "end_time": "48.44",
                        "word": "jobs",
                        "confidence": "0.98"
                    },
                    {
                        "start_time": "48.44",
                        "end_time": "48.90",
                        "word": "compared",
                        "confidence": "0.96"
                    },
                    {
                        "start_time": "48.90",
                        "end_time": "48.96",
                        "word": "to",
                        "confidence": "0.17"
                    },
                    {
                        "start_time": "48.96",
                        "end_time": "49.08",
                        "word": "new",
                        "confidence": "0.97"
                    },
                    {
                        "start_time": "49.08",
                        "end_time": "49.37",
                        "word": "york",
                        "confidence": "0.98"
                    },
                    {
                        "start_time": "49.37",
                        "end_time": "49.49",
                        "word": "and",
                        "confidence": "0.92"
                    },
                    {
                        "start_time": "49.49",
                        "end_time": "49.83",
                        "word": "la",
                        "confidence": "0.56"
                    }
                ]
            }
        ]
    },