

Tutorials
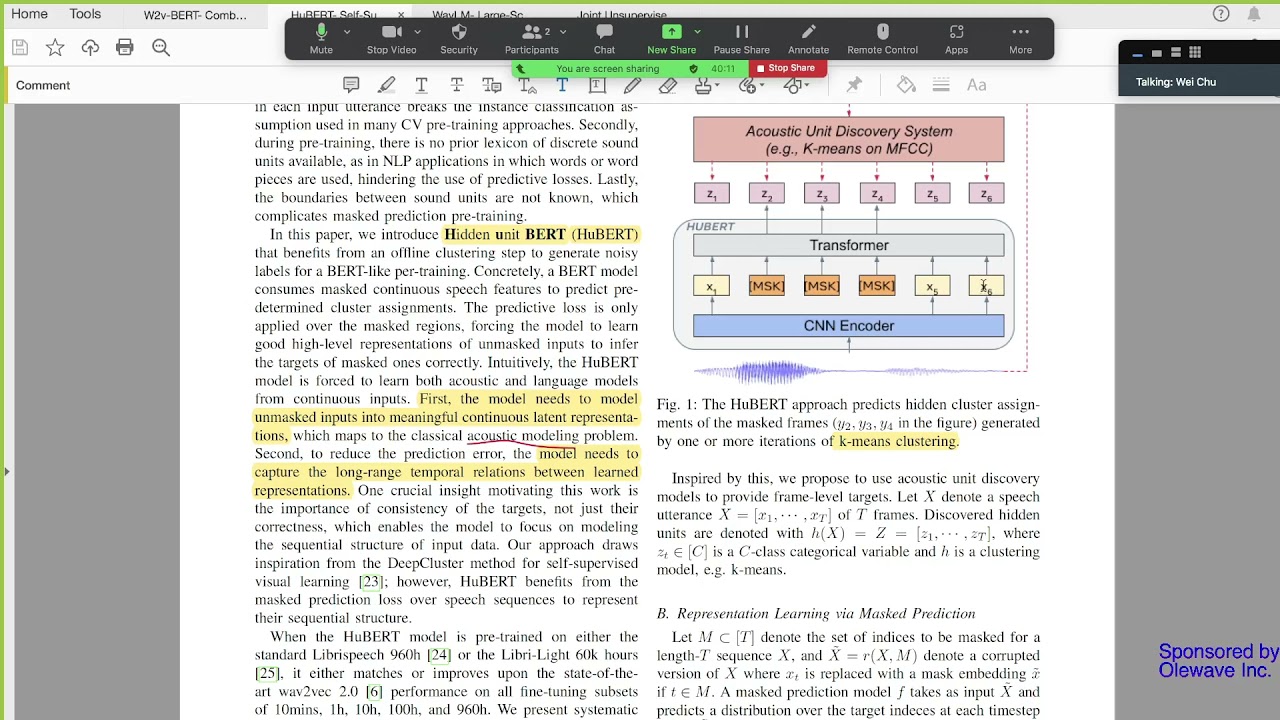
HuBERT:通過隱藏單位的掩蓋預測進行自監督語音表示學習
wav2vec 2.0 通過對比自監督改變了遊戲規則,但 HuBERT 提出了一個更尖銳的問題:如果我們完全跳過對比技巧,只在語音上進行 BERT 風格的掩蓋預測會怎樣?


Tutorials
UniSpeech-SAT:具有說話人感知預訓練的通用語音表示學習
自監督語音模型往往能很好地學習語音內容,但把說話人身份視為事後考慮——這對ASR是可以的,但對說話人驗證、說話人分割或語音克隆是很糟糕的。


Tutorials
用於語音增強和識別聯合訓練的SNRi目標訓練
語音增強和ASR的聯合訓練聽起來很簡單——只需通過去噪器反向傳播識別損失——但實踐中很混亂,因為激進的去噪往往會扭曲聲學模型所依賴的特徵
